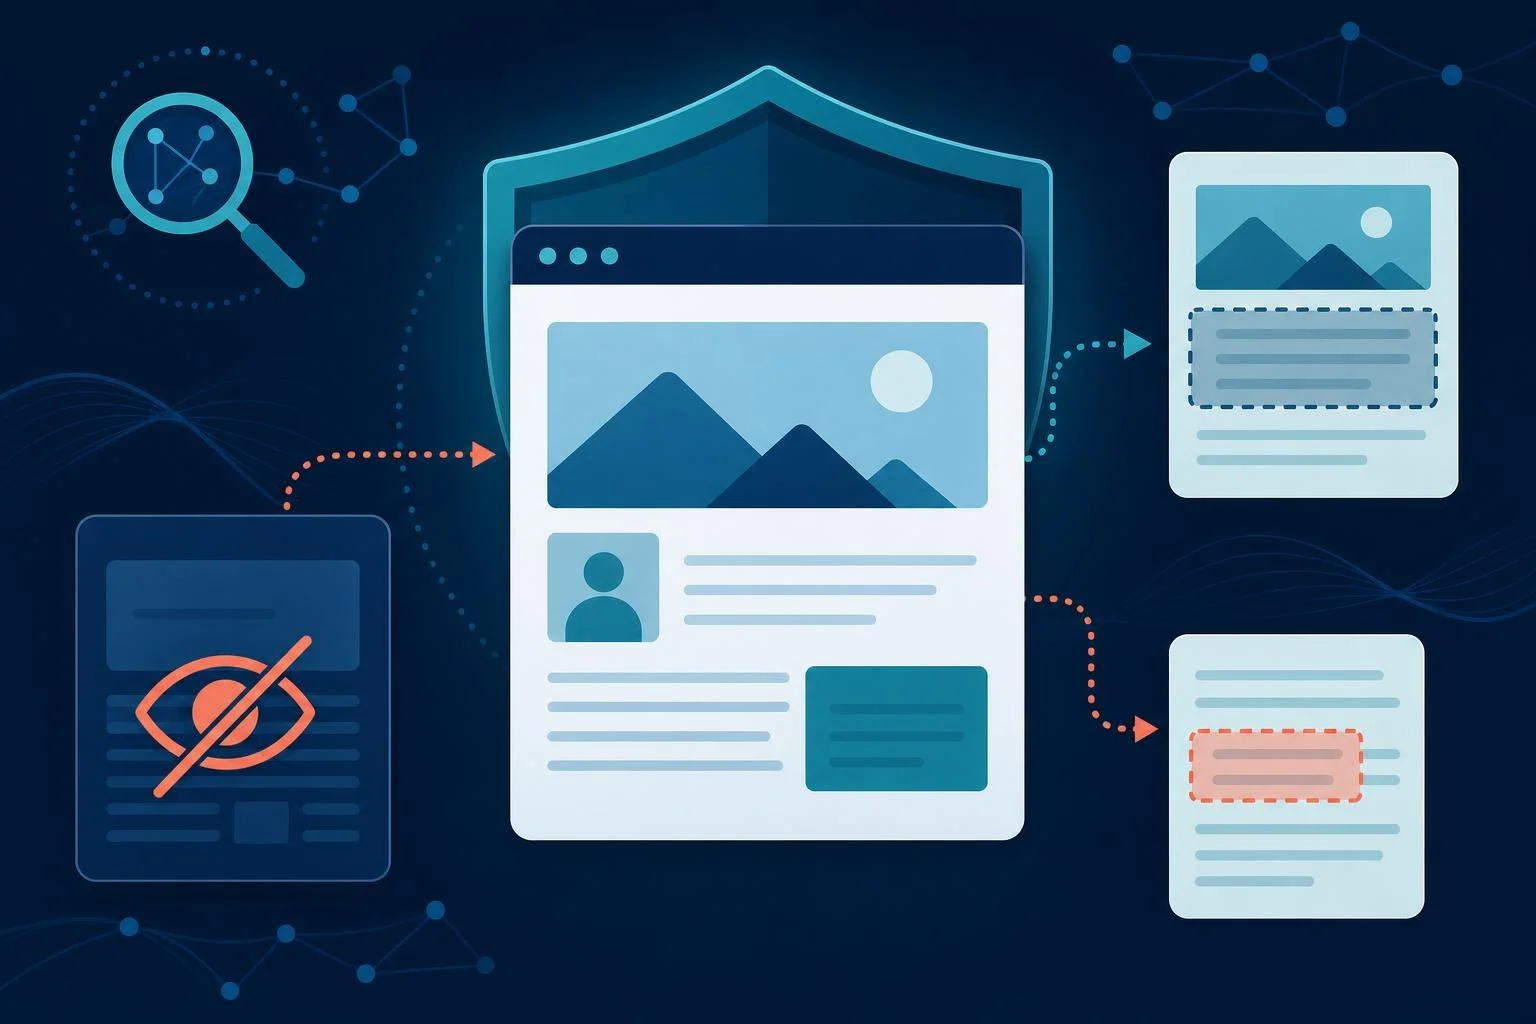
AI検索への露出を制限したい場合は、守りたい範囲に応じて指定を分けます。ページ自体を検索結果から外すならnoindex、ページは残して検索結果やGoogleのAI機能での抜粋を抑えるならnosnippet、ページ内の一部だけを抜粋対象から外すならdata-nosnippetが基本です。
ただし、これらは主にGoogle検索における掲載・表示を制御する仕組みです。Google以外を含むすべてのAIサービスによる取得、学習、回答での言及、第三者サイトへの転載までを一律に止める万能な設定ではありません。
検索流入が重要なページでは、AI検索対策だけを理由にnoindexを付けると、通常のGoogle検索からの流入も失う可能性があります。ページ全体を外す必要があるのか、抜粋だけを抑えたいのか、保護したい文章だけを囲えばよいのかを先に整理しましょう。
AI検索への掲載を制限するなら、目的に応じて指定を選ぶ
最初に決めるべきことは、「URLをGoogle検索に出したくない」のか、「URLは出してよいが本文を検索結果やAI回答に抜粋されたくない」のかです。目的が異なる指定を重ねると、必要以上に検索での見つかりやすさを下げるおそれがあります。
| 目的 | 主な指定 | Google検索への主な影響 | 向いているケース |
|---|---|---|---|
| ページ自体を出したくない | noindex | クロール後、検索結果への掲載を抑制 | 完了画面、テストページ、検索流入を想定しないURL |
| ページは出すが、本文の抜粋を抑えたい | nosnippet | テキストスニペットや動画プレビューを抑制 | 検索流入は維持しつつ、本文の直接的な要約利用を避けたいページ |
| 特定の文章だけを抜粋対象から外したい | data-nosnippet | 指定要素内のテキストをスニペット対象から除外 | 独自ノウハウ、限定条件、補足情報を部分的に扱う場合 |
ページ自体を検索結果から外すならnoindex
noindexは、GooglebotがページまたはHTTPレスポンスヘッダーから指定を認識した場合に、当該URLをGoogle検索結果へ表示しないようにするルールです。検索結果にURLを載せないことが目的なので、SEO経由の流入を期待する記事、商品ページ、サービスページには通常向きません。
たとえば、フォーム送信後に表示されるサンクスページ、テスト環境のページ、検索から直接訪問される意味が薄い絞り込みURLは、noindexを検討する対象になります。一方、AI回答で引用される可能性を下げたいだけなら、いきなりnoindexにせず、nosnippetやdata-nosnippetで足りるかを確認してください。
出典:Google Search Central「Block Search indexing with noindex」
ページは残し、検索結果やGoogleのAI機能での抜粋を抑えるならnosnippet
nosnippetは、URLをインデックス対象のままにしつつ、Google検索結果のテキストスニペットと動画プレビューを表示しないようにする指定です。Googleは、nosnippetがGoogle検索、Google画像検索、Discover、AI Overviews、AI Modeを含む検索結果の形式に適用され、AI OverviewsとAI Modeへの直接入力としてコンテンツが使われないようにすると案内しています。
ページの存在を残したまま抜粋を抑えたい場合に、nosnippetは有力な選択肢です。ただし、説明文が表示されなくなることで、検索ユーザーがページ内容を判断しにくくなり、クリック率に影響する可能性があります。タイトル、サイト名、表示URLだけでも訪問価値が伝わるかを確認してから導入しましょう。
出典:Google Search Central「Robots Meta Tags Specifications」
ページ内の一部分だけを抜粋対象から外すならdata-nosnippet
data-nosnippetは、span、div、section要素に付与し、その要素内のテキストをGoogle検索のスニペットに使わないよう指定するHTML属性です。ページ全体は検索対象として残しながら、公開したい本文と、抜粋させたくない補足情報を分けたい場合に適しています。
たとえば、記事の結論や概要は通常どおり検索対象にし、詳細な手順、独自のチェックリスト、限定公開に近い補足、契約上の個別条件などだけをdata-nosnippetで囲む方法があります。GoogleはAI機能に表示する情報を制限する方法としてdata-nosnippetも案内しているため、ページ全体の露出を止めずに範囲を絞りたいときに検討できます。
出典:Google Search Central「AI Features and Your Website」
noindex・nosnippet・data-nosnippetの違いとSEOへの影響
3つの指定は、いずれもAI検索対策としてまとめられがちですが、検索結果に及ぼす影響は大きく異なります。特にnoindexは検索流入そのものを失う判断になり得るため、ページ単位の役割を確認して使い分けることが重要です。
noindexは検索流入を見込まないページに限定する
noindexを付けたページは、Google検索結果に表示されないことを意図した設定です。そのため、検索経由で読者を集める記事や、指名検索で見つけてほしい会社案内、比較検討されるサービスページには付けるべきではありません。
また、noindexはページ品質の改善や重複対策の代替手段ではありません。公開を続ける価値があり、検索ユーザーにも役立つ内容なら、まずは内容の統合、正規URLの整理、内部リンクの見直しなどを検討します。AI検索での露出だけを懸念してnoindexにすると、本来得られたはずの通常検索流入まで止めてしまいます。
nosnippetは検索結果の訴求力やリッチな表示に影響しうる
nosnippetを設定すると、Google検索結果の本文説明として表示されるテキストスニペットが出なくなります。検索順位を直接下げるための指定ではありませんが、検索結果で内容が伝わりにくくなれば、ユーザーのクリック判断には影響し得ます。
なお、nosnippetはテキストスニペットや動画プレビューを対象とする指定であり、静的な画像サムネイルが常に消えるわけではありません。画像の扱いも制限したい場合は、目的に応じてmax-image-previewやnoimageindexなど、別の制御を確認してください。
出典:Google Search Central「Robots Meta Tags Specifications」
data-nosnippetでは同じ情報の別経路にも注意する
data-nosnippetで囲んだとしても、同じ内容がページ本文の別の場所、見出し、画像の代替テキスト、構造化データ、PDF、外部サイトの転載記事などに存在すれば、その情報全体が検索結果やAI回答で触れられなくなるとは限りません。
保護したい情報はページ全体で重複を点検することが必要です。Googleは、data-nosnippet要素内にあっても構造化データは検索結果で利用できると案内しています。レシピ、商品、FAQなどの構造化データに同じ数値や文章を記載している場合は、HTML本文だけでなく構造化データの内容も確認してください。
出典:Google Search Central「Robots Meta Tags Specifications」
HTMLでの設定方法:ページ全体と特定箇所を正しく書き分ける
noindexとnosnippetは、原則としてページのhead内にmeta robotsタグとして出力します。data-nosnippetはheadには書かず、本文中で対象テキストを含むHTML要素へ直接付ける点が違います。
noindexとnosnippetをmeta robotsで指定する例
ページ全体をGoogle検索から外す場合は、HTMLのhead内に次の記述を出力します。
<meta name="robots" content="noindex">ページは検索対象に残し、検索結果やGoogleのAI機能における本文の抜粋を抑えたい場合は、次のように記述します。
<meta name="robots" content="nosnippet">noindexとnosnippetを同時に書くことも技術的には可能です。
<meta name="robots" content="noindex, nosnippet">ただし、noindexが認識されればページ自体がGoogle検索に出なくなるため、検索結果での抜粋も実質的に不要になります。両方を併記する前に、ページを検索結果へ残す必要があるかを判断してください。meta robotsの複数ルールはカンマ区切りで指定できます。
出典:Google Search Central「Robots Meta Tags Specifications」
HTMLを編集できないファイルではX-Robots-Tagを使う
PDF、画像、動画ファイルなど、HTMLのheadにmetaタグを書けないリソースには、HTTPレスポンスヘッダーのX-Robots-Tagを使えます。たとえばPDFをGoogle検索の対象から外す場合、Webサーバーが返すレスポンスヘッダーに次のような指定を追加します。
X-Robots-Tag: noindexX-Robots-TagはApache、Nginx、CDN、ホスティングサービスの設定などで追加することがあり、具体的な設定方法はサーバー環境によって異なります。サイト全体のPDFへ一律に適用すると、公開資料まで検索から消えるおそれがあるため、対象パスや対象拡張子を慎重に指定してください。
出典:Google Search Central「Robots Meta Tags Specifications」
data-nosnippetを対象要素に付与する例
本文の一部だけを対象外にする場合は、次のようにspan、div、sectionのいずれかにdata-nosnippetを付けます。
<p>この記事の概要は検索結果の説明文に使われる可能性があります。</p>

<section data-nosnippet>
  <h3>会員向けの詳細な運用メモ</h3>
  <p>この範囲のテキストはスニペット対象から除外します。</p>
</section>data-nosnippetは真偽値属性のため、data-nosnippet="false"のように値を書いても、属性が存在する限り対象外として扱われます。保護範囲は必要最小限にし、開始タグと終了タグの対応を必ず確認してください。タグの閉じ忘れがあると、意図しない後続コンテンツまで対象外になる可能性があります。
また、JavaScriptで既存要素のdata-nosnippetを後から追加・削除する実装は避けるのが無難です。Googleはレンダリングが常に保証されるわけではないため、可能なら初期HTMLまたはDOM生成時点で属性を出力してください。
出典:Google Search Central「Robots Meta Tags Specifications」
WordPressで実装する際の進め方
WordPressでは、利用テーマ、ブロックエディター、SEOプラグイン、キャッシュ機能の組み合わせによって設定場所が変わります。管理画面に設定欄があっても、最終的に意図したタグや属性が公開ページへ出力されているかを確認することが重要です。
ページ単位のnoindex・nosnippetは出力されるheadを確認する
noindexは、SEOプラグインやテーマのページ編集画面にある検索エンジン向け設定から指定できる場合があります。しかし、nosnippetを個別に指定できるか、既存のrobots設定と競合しないかは製品ごとに異なります。
制作会社へ依頼する場合は、「このURLのhead内に<meta name="robots" content="nosnippet">を出力したい」のように、目的と完成形を具体的に伝えると認識違いを減らせます。公開後はブラウザのページソースを開き、head内に指定が出力されていることを確認してください。
data-nosnippetは属性を出力できる編集方法を選ぶ
data-nosnippetは、カスタムHTMLブロック、テーマテンプレート、独自ショートコードなど、任意のHTML属性を保持できる方法で実装します。ビジュアルエディターやページビルダーによっては、保存時に独自属性が削除されたり、要素構造が変更されたりすることがあります。
公開後の実際のHTMLを必ず確認することが大切です。編集画面上の見た目だけで判断せず、公開URLのソースまたは開発者ツールで、対象のspan、div、sectionにdata-nosnippetが残っているかを確認します。
robots.txtとAIクローラー制御は、検索結果の制御とは別に考える
robots.txt、noindex、nosnippet、data-nosnippetは似た文脈で語られますが、制御する対象が異なります。robots.txtは主にクローラーがURLへアクセスできるかを示すものであり、検索結果への掲載や抜粋の制御にはnoindexやスニペット制御を使い分けます。
robots.txtだけではnoindexの代わりにならない
Googleにnoindexを認識させるには、Googlebotがページをクロールし、meta robotsタグまたはX-Robots-Tagを確認できる必要があります。robots.txtで先にクロールを拒否すると、Googlebotはnoindexを見つけられず、外部リンクなどを手がかりにURLだけが検索結果へ表示される可能性があります。
したがって、Google検索結果から外したいURLは、robots.txtでブロックするのではなく、まずnoindexをクロール可能な状態で認識させることが基本です。機密情報を守る目的なら、noindexではなく認証やパスワード保護、公開停止など、そもそも第三者がアクセスできない方法を検討してください。
出典:Google Search Central「Robots.txt Introduction and Guide」
他社のAIサービスは公式のクローラー仕様を個別に確認する
Google向けのmeta robotsタグやdata-nosnippetを設定しても、他社のAI検索、生成AI、要約サービスまで同じように制御できるとは限りません。各サービスがどのクローラー名、robots.txtの解釈、データ利用ポリシーを採用しているかは異なるため、対象サービスの公式ドキュメントを個別に確認してください。
Googleでは、Google検索のAI機能に表示する情報の制御としてnoindex、nosnippet、data-nosnippetなどを案内しています。一方、Gemini AppsやVertex AI API for Geminiの将来世代の学習や一部のグラウンディングについては、Google-Extendedというrobots.txtのトークンが別途用意されています。Google-ExtendedはGoogle検索への掲載や検索順位には影響しません。
出典:Google Crawling Infrastructure「Google’s common crawlers」
設定後の確認手順と反映されないときの確認点
設定は「書いた」だけでは完了ではありません。HTMLの出力、HTTPヘッダー、robots.txtとの競合、Googlebotが取得した内容、検索結果の更新状況を順に確認すると、原因を切り分けやすくなります。
ソースとHTTPレスポンスヘッダーで指定の有無を確認する
noindexとnosnippetは、公開ページのソースを開き、head内のmeta robotsタグを確認します。data-nosnippetは、本文の対象要素に属性が残っているかを確認してください。PDFなどでX-Robots-Tagを使う場合は、ブラウザの開発者ツール、サーバーのヘッダー確認機能、HTTPレスポンスを確認できるツールなどで、実際にヘッダーが返っているかを確認します。
キャッシュプラグイン、CDN、HTML最適化機能を使っているサイトでは、設定変更後に古いHTMLが配信されることがあります。WordPressのキャッシュ、サーバーキャッシュ、CDNキャッシュを必要に応じて更新したうえで、ログインしていない状態でも確認しましょう。
Google Search Consoleでクロールとインデックス状況を確認する
Google Search ConsoleのURL検査では、Googleがクロール時に受け取ったHTMLを確認でき、noindexやプレビュー制御がGooglebotに見えているかを調べる際に役立ちます。noindexの場合は、ページのインデックス登録レポートで除外理由も確認します。
変更後にGoogle検索やAI機能の表示がすぐ変わるとは限りません。Googleは、再クロールと処理に数日から数か月かかる場合があると案内しています。固定の日数を前提にせず、URL検査で再クロールをリクエストしつつ、実装が正しいかを優先して確認してください。
出典:Google Search Central「AI Features and Your Website」
キャッシュ・転載・引用済みコンテンツは別途対応が必要になることがある
自サイトへnoindexやnosnippetを追加しても、すでに第三者サイトへ転載された文章、SNS投稿、外部サイトの引用、別URLに残るPDF、過去に取得されたキャッシュまで自動で削除されるわけではありません。自サイトの公開ページで制御できる範囲と、外部に複製された情報への対応は分けて考える必要があります。
内容が機密情報や個人情報である場合は、タグだけに依存せず、ページの削除、認証設定、アクセス権の見直し、転載元への削除依頼などを状況に応じて検討してください。
よくある質問
実装時に混同しやすいポイントを、判断に必要な範囲で補足します。
AI Overviewだけを止めて、通常の検索スニペットは残せますか?
Googleの案内上、nosnippetはGoogle検索、Google画像検索、Discover、AI Overviews、AI Modeを含む検索結果形式に適用されます。AI Overviewだけを個別に除外する指定ではありません。通常検索のスニペットを維持したい場合は、ページ全体のnosnippetではなく、必要箇所だけdata-nosnippetで囲めるかを検討してください。
robots.txtだけでAI検索への表示を止められますか?
robots.txtは主にクロールアクセスを制御するためのものです。Google検索からURLを外したい場合、robots.txtだけでは不十分であり、noindexまたは認証・削除などを目的に応じて使う必要があります。また、他社AIサービスに対する効果は、そのサービスがrobots.txtをどのように扱うかに依存します。
WordPressで設定場所が分からない場合はどうすればよいですか?
利用中のテーマやSEOプラグインの設定画面を探す前に、実現したい出力を明確にします。ページ単位ならmeta robotsタグ、部分指定ならdata-nosnippet属性、PDFなどならX-Robots-Tagが候補です。管理画面に対応項目がない場合は、子テーマ、独自プラグイン、サーバー設定での対応が必要になることがあるため、制作担当者へ完成形のHTMLまたはヘッダー指定を伝えてください。
まとめ:守りたい範囲を決めてから指定を実装する
AI検索への掲載を制限する際は、まず検索結果からURLそのものを外す必要があるかを判断します。ページをGoogle検索から除外するならnoindex、ページは残して検索結果やGoogleのAI機能での抜粋を抑えるならnosnippet、特定の文章だけを対象外にしたいならdata-nosnippetが適しています。
検索流入を残すなら部分的な制御から検討するのが基本です。実装後は、公開ページのHTML、HTTPレスポンスヘッダー、robots.txtとの競合、Google Search ConsoleのURL検査を確認してください。Google向けの指定だけで全AIサービスや外部転載を完全に制御できるわけではないため、重要情報は公開範囲やアクセス制御そのものも見直しましょう。