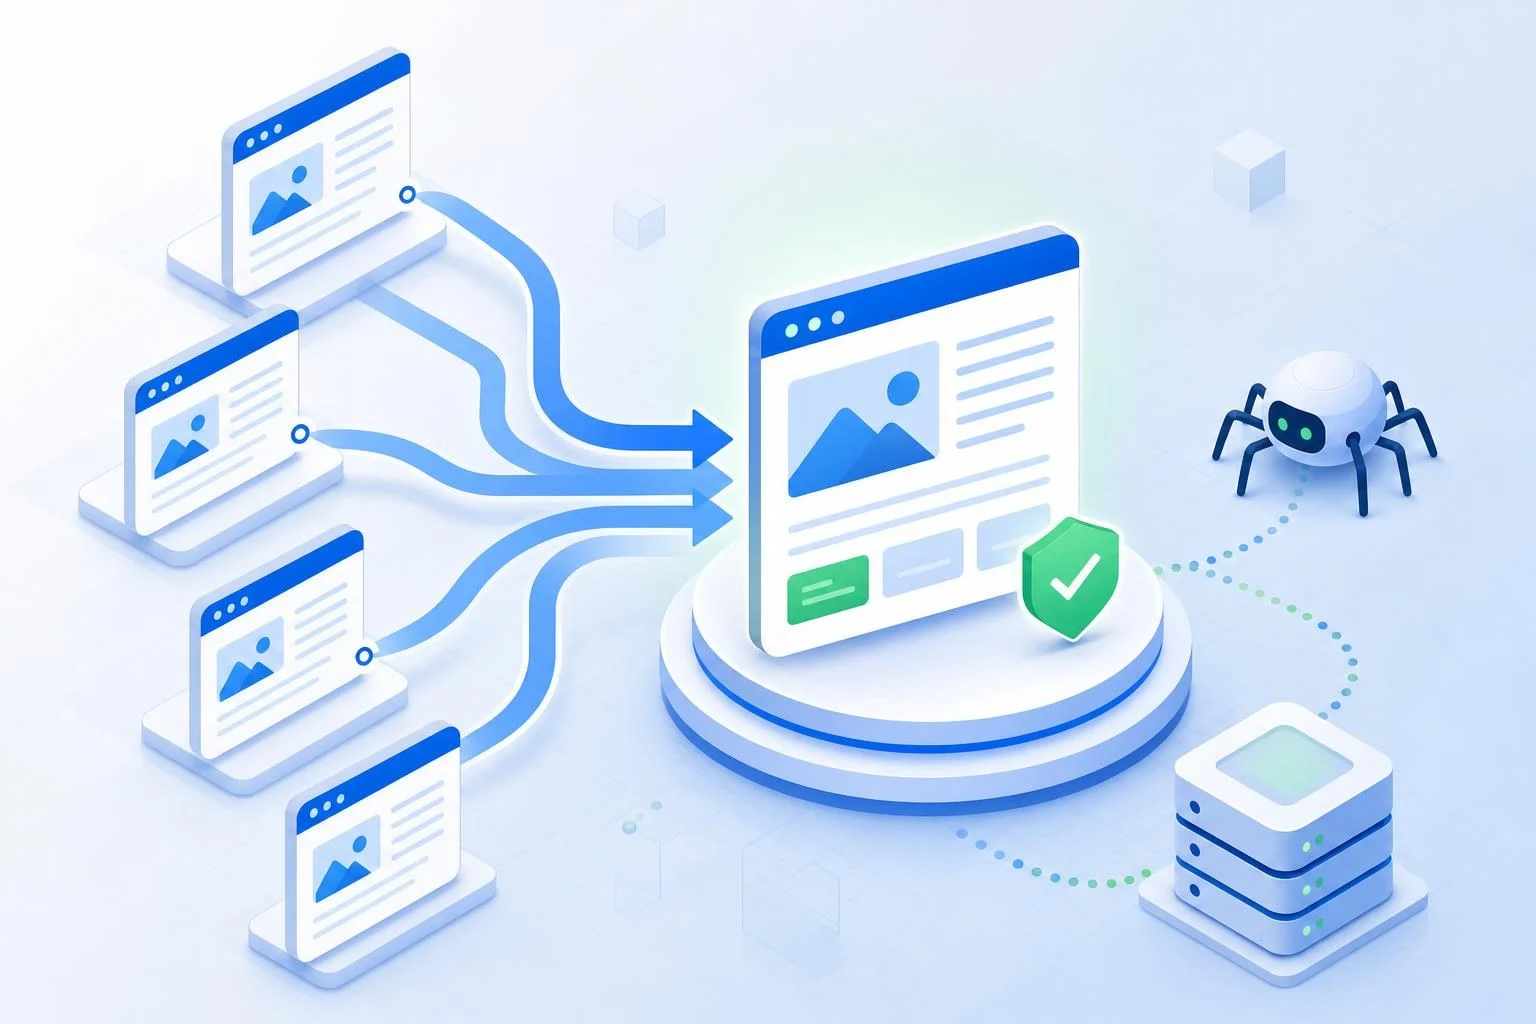
重複コンテンツとは、同じ内容、または非常によく似た内容が複数のURLで公開されている状態です。重複しているだけで直ちにGoogleペナルティになるわけではありません。ただし、GoogleがどのURLを検索結果に表示し、評価の対象として扱うべきかを判断しにくくなる場合があります。
対策の基本は、重複するURLのグループごとに、検索流入を集めたい正規URLを1つ決めることです。不要なURLは301リダイレクトで統合し、利用者向けに公開を続ける類似URLにはcanonicalを指定します。さらに、内部リンク、XMLサイトマップ、URL表記も正規URLへそろえます。
この記事では、重複コンテンツが起きる主な原因、301リダイレクト・canonical・noindexの使い分け、WordPressやECサイトでの注意点、Google Search Consoleで確認する手順を、実務で判断しやすい順に解説します。
重複コンテンツは正規URLを1つに決めて対応する
重複コンテンツへの対応では、まず複数URLの中から検索結果に表示させたい代表URLを決めることが重要です。たとえば、httpとhttps、wwwの有無、末尾スラッシュの有無で同じページを表示できる場合は、どれか1つを正式なURLとして選びます。
Googleは、リダイレクト、rel="canonical"、サイトマップ、内部リンクなどの情報を基に正規URLを選択します。canonicalは重要な指定ですが、絶対的な命令ではありません。サイト内の情報を矛盾なくそろえることで、意図したURLが正規URLとして扱われやすくなります。
出典:Google Search Central「How to Specify a Canonical with rel="canonical" and Other Methods」
最初に確認する正規化のチェックポイント
修正作業の前に、サイト全体で採用するURLルールを決めます。ルール決定後に個別URLを振り分けると、リダイレクトやcanonicalの設定が複雑になりにくくなります。
- httpsとhttpのどちらを正規URLにするか
- wwwあり・なしのどちらを採用するか
- 末尾スラッシュ、index.html・index.php、大文字・小文字の表記を統一できているか
- 不要な旧URLや表記違いを301リダイレクトできているか
- 公開を残す類似ページに正しいcanonicalがあるか
- 本文リンク、メニュー、パンくず、XMLサイトマップが正規URLを参照しているか
- Google Search Consoleで、指定した正規URLとGoogleが選択した正規URLを確認したか
canonicalだけを設定し、内部リンクやサイトマップでは別のURLを使い続ける状態は避けてください。検索エンジンに送るシグナルが食い違うと、意図した正規URLが採用されないことがあります。
重複コンテンツがSEOに与える影響
同一または類似したページが複数存在しても、通常はそれだけでスパム行為や手動対策の対象になるわけではありません。問題は、Googleと利用者の双方にとって、どのページが代表なのかが分かりにくくなることです。
Googleは重複・類似ページの集合から正規URLを選ぼうとします。その結果、運営者が意図しないURLが検索結果に表示されたり、リンクなどのシグナルが複数URLに分かれたりする場合があります。重複対策の目的は表示先を明確にすることです。
出典:Google Search Central「How to Specify a Canonical with rel="canonical" and Other Methods」
Googleが指定したcanonicalを採用しない主な理由
Googleは、canonical先との内容の近さ、リダイレクト、内部リンク、サイトマップなどを総合して正規URLを判断します。canonical先が404ページやnoindexページである、内容が十分に似ていない、内部リンクが別URLへ集中しているといった状態では、指定と異なるURLが選ばれることがあります。
正規化に関する情報を一貫させることが大切です。canonical先は正常に表示できるページにし、サイトマップと内部リンクでも同じURLを支持してください。
重複コンテンツが発生する主な原因
重複コンテンツは、本文をコピーした場合だけに起こるものではありません。同一ページを複数URLで表示できる設定、CMSのアーカイブ、ECサイトの絞り込みURLなど、日常的な運用でも発生します。
確認時は、URLが違うだけで同じ内容を返していないか、派生ページに独自の検索価値があるかを見ます。すべての類似ページを一律に統合する必要はありません。
http・https、www、末尾スラッシュ、indexファイルの併存
URL表記の違いは代表的な重複原因です。たとえば、次のようなURLで同じ内容が表示される場合、検索エンジンには別URLとして扱われる可能性があります。
- http://example.com/ と https://example.com/
- https://example.com/ と https://www.example.com/
- https://example.com/service と https://example.com/service/
- https://example.com/ と https://example.com/index.html
- URL内の大文字・小文字の違い
今後使わない表記は、正規URLへ恒久的な301リダイレクトを設定するのが基本です。GoogleはURLの大文字・小文字を区別して扱うため、サーバー側で同じページを返すならURL形式を統一したほうが安全です。
出典:Google Search Central「URL Structure Best Practices for Google Search」
URLパラメータ、絞り込み、並び替え、ページネーション
広告計測用パラメータ、ECサイトの色・サイズ絞り込み、価格順の並び替え、サイト内検索は、多数のURLを生みやすい要因です。計測パラメータだけが異なり、表示内容が同じ商品ページなら、代表の商品URLへcanonicalを指定する判断が考えられます。
一方、「メンズ白スニーカー」のような明確な検索意図に答え、商品選びに役立つ説明と適切な一覧を持つ絞り込みページは、独立したページとして残す選択肢があります。URLの数ではなくページ固有の価値で判断します。
ページネーションでは、各ページに異なる商品や記事が表示されるなら、すべてを1ページ目へcanonicalする設計は慎重に判断してください。2ページ目以降の内容をGoogleが発見しにくくなるおそれがあるため、通常は各ページが自分自身を正規URLとして示す方法を検討します。
WordPressのアーカイブ・添付ページ・検索結果ページ
WordPressでは、カテゴリ、タグ、日付、投稿者アーカイブ、添付ファイルページ、サイト内検索結果、ページ送りURLを点検します。テーマ、SEOプラグイン、WordPressの設定によって、canonicalやインデックス設定の出力が異なるためです。
カテゴリやタグのアーカイブをnoindexにすべきかは一律には決められません。投稿タイトルを並べるだけの一覧は検索価値が限られることがありますが、テーマの解説、選び方、代表記事への案内を加えたカテゴリページは独自の価値を持ち得ます。アーカイブを残す目的を先に決めましょう。
商品バリエーション、印刷用ページ、転載記事
ECサイトでは、色・サイズ・容量などの商品バリエーションごとにURLがあると、説明がほぼ同じページになりがちです。在庫、仕様、画像、適合情報など購入判断に必要な差があるなら個別ページとして残す価値があります。差が小さい場合は、代表商品URLへcanonicalを向けることを検討します。
印刷用ページやPDF版などの派生コンテンツも、主ページとの役割を整理してください。外部メディアへの転載では、転載元・転載先のどちらを検索結果で優先したいかを事前に合意し、可能であれば転載先から元記事へcanonicalを設定する方法を検討します。
301リダイレクト・canonical・noindexの使い分け
301リダイレクト、canonical、noindexは目的が異なります。判断の基準は、そのURLを利用者に公開し続ける必要があるか、検索結果に出すべきか、独自の情報があるかです。
| 状況 | 主な対応 | 考え方 |
|---|---|---|
| 旧URL・URL表記違いなど不要なURL | 301リダイレクト | 利用者と検索エンジンを正規URLへ移動させる |
| 公開を残す必要がある類似URL | canonical | 優先して評価・表示させたいURLを示す |
| 検索結果に表示する必要がないページ | noindex | 検索結果から除外することが目的 |
| 異なる検索意図や固有情報があるページ | 内容の差別化 | 独立したページとして成立させる |
不要になったURLは301リダイレクトで統合する
旧URL、http版、wwwあり版、indexファイル付きURLなど、今後使わないURLは正規URLへ301リダイレクトします。転送先は、内容が最も対応するページにしてください。
削除した個別商品を無関係なトップページへ一律に転送すると、利用者にも検索エンジンにも意図が伝わりにくくなります。後継商品や対応する代替ページへ転送することが基本です。
出典:Google Search Central「Redirects and Google Search」
公開を残す類似ページにはcanonicalを指定する
ユーザー向けに公開を続ける必要がある一方、検索結果では代表ページを優先したい場合は、head要素内にrel="canonical"を設定します。計測パラメータ付きURL、印刷用ページ、一部のバリエーションページなどが対象になり得ます。
canonicalは重複または非常に似たページ間で使うことが前提です。正規URL自身にも自己参照canonicalを設定し、canonical先、内部リンク、XMLサイトマップで示すURLを一致させてください。canonical先は正常にアクセスできるURLにします。
noindexは検索結果に出したくないページに使う
noindexは、そのページをGoogle検索結果に表示させないための指示です。正規URLへの評価集約を主目的とする設定ではありません。重複ページの代表URLを示したい場合に、canonicalの代わりとして安易に使うことは避けましょう。
また、robots.txtでクロールをブロックしたページでは、Googlebotはページ内のnoindexを確認できません。noindexを有効にしたいページは、検索エンジンがページをクロールして指示を読める状態にしておく必要があります。
出典:Google Search Central「Robots Meta Tags Specifications」
正規URLへSEO評価を集約する実装手順
正規化はタグを追加して終わる作業ではありません。正規URLの設計、重複URLの洗い出し、実装、サイト内シグナルの統一、Search Consoleでの検証までを一連の作業として進めます。
1. 正規URLのルールと代表ページを決める
サイト全体について、httpsの利用、wwwの有無、末尾スラッシュ、URLの小文字化などのルールを決めます。そのうえで、重複しているURL群ごとに代表ページを1つ選びます。
代表URLは、利用者に共有・保存してほしいURL、今後も維持できるURL、内容が最も完全なURLを基準に選びます。頻繁に変えない長期運用可能なURLを選ぶことが大切です。
2. 重複URLを洗い出して対応を分類する
重複URLは、XMLサイトマップ、Google Search Console、CMS設定、アクセス解析のランディングページ、サーバーログ、サイトクロールツールなどから確認します。検索結果で想定外のURLが表示されていないかを調べることも有効です。
洗い出したURLは、不要なら301リダイレクト、公開を残す類似ページならcanonical、検索結果に不要ならnoindex、独自価値があるなら内容差別化という形で分類します。URL単位ではなくページの役割で判断します。
3. 内部リンク・canonical・サイトマップを統一する
正規URLを決めたら、メニュー、パンくず、本文リンク、関連記事、画像リンクなどの遷移先を見直します。XMLサイトマップには、原則としてインデックスさせたい正規URLだけを含めます。
多言語サイトでhreflangを使う場合も、各言語ページの正規URL関係を整えたうえで設定してください。内部リンクとサイトマップも正規URLを支持する状態が理想です。
4. Search ConsoleのURL検査で確認する
設定後は、Google Search ConsoleのURL検査ツールで対象URLを確認します。ページのインデックス登録に関する情報では、運営者が指定した「ユーザー指定の正規URL」と、Googleが選んだ「Google が選択した正規URL」を確認できます。
両者が異なる場合は、canonical先との内容差、リダイレクト、内部リンク、サイトマップ、robots設定、HTTPステータスを見直してください。原因ラベルだけでなくGoogleの選択結果を確認します。
出典:Google Search Console ヘルプ「URL Inspection Tool」
5. 変更後も定期的に監査する
重複コンテンツは、テーマ変更、プラグイン導入、EC機能の追加、計測設定の変更、新しいアーカイブ作成などをきっかけに再発します。新機能の公開時には、URLパラメータ、canonical出力、サイトマップの内容を確認してください。
特に大規模サイトでは、URLルールと正規化方針を文書として残すことが重要です。担当者間で正規URLの基準を共有すると、後からの修正コストを抑えやすくなります。
WordPressとECサイトでの正規化の注意点
WordPressやECプラットフォームでは、標準機能、テーマ、プラグインが自動的に多様なURLを生成します。個別記事のcanonicalだけでなく、アーカイブ、検索結果、フィルタ、商品バリエーションを含めて確認する必要があります。
WordPressはアーカイブを残す価値で判断する
カテゴリ・タグ・日付・投稿者アーカイブを、すべて一律にnoindexにする必要はありません。カテゴリページがテーマの入口として機能し、独自の解説や適切な記事整理を提供しているなら、検索流入を得られる可能性があります。
一方、タグが増えすぎて似た一覧が大量に生まれている場合や、投稿者アーカイブが実質的に同じ内容を繰り返している場合は、インデックスさせる価値を見直す余地があります。テーマとプラグインの出力設定も確認しましょう。
ECサイトはフィルタURLとバリエーションを分けて考える
ECサイトのフィルタURLは、検索流入を狙う一覧ページと、サイト内操作のためだけのURLを分けると判断しやすくなります。前者は商品説明や選び方を整えて独立ページとして育て、後者はcanonicalやnoindexなどで管理します。
商品バリエーションでは、色・サイズ・型番ごとに購入者が到達する意味があるかを確認してください。在庫、仕様、画像、適合情報が異なるなら独立ページとして成立し得ます。購入判断に必要な差があるかが判断基準です。
重複コンテンツ・コピーコンテンツ・類似コンテンツの違い
重複コンテンツは、同じサイト内または複数サイト間で、同一または非常に近い内容が複数URLにある状態を指します。URL表記の違いで同じページが開くケースも含まれます。
コピーコンテンツは、他者の文章や画像を無断で複製・流用する文脈で使われることが多い言葉です。SEOに加え、著作権、契約、ブランドの信頼性にも関わります。類似コンテンツは、テーマや構成が近いものの、対象や目的、情報量に違いがあるページまで含み得ます。
文字列の一致率だけで問題の有無は判断できません。各ページが誰のどの疑問に答えるものかを基準に、統合、差別化、維持を判断してください。
まとめ|代表URLとサイト内シグナルを一致させる
重複コンテンツは、存在するだけで自動的にペナルティを受けるものではありません。しかし放置すると、Googleが意図しないURLを正規URLとして選ぶ可能性があります。
- 重複グループごとに、検索結果へ出したい正規URLを1つ決める
- 不要なURLは301リダイレクトで正規URLへ統合する
- 公開を残す類似ページにはcanonicalを設定する
- noindexは検索結果に出さないための設定として使う
- 内部リンク、サイトマップ、canonicalの参照先を正規URLへ統一する
- Search ConsoleのURL検査でGoogleが選んだ正規URLを確認する
まずは、http・https、www有無、末尾スラッシュ、URLパラメータなど、同じページへ到達できるURLから確認してください。代表URLとサイト内の案内を一致させることが、重複コンテンツ対策の最も重要な基本です。