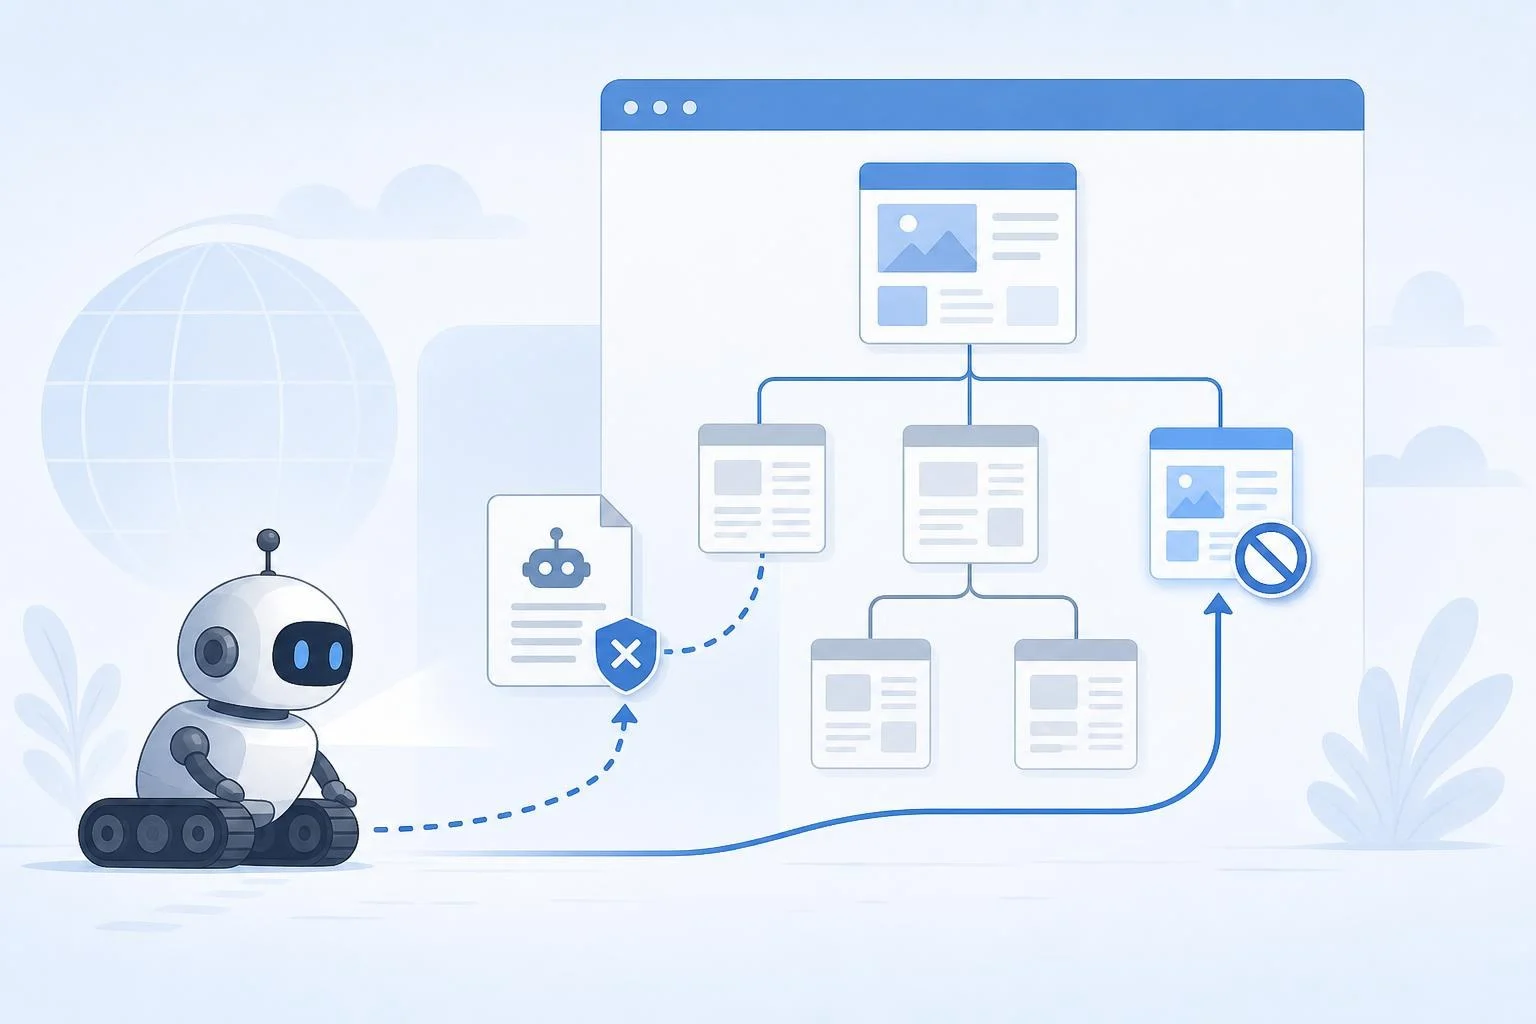
検索結果に出したくないページがある場合は、原則としてrobots.txtではなくnoindexを設定します。robots.txtはクローラーによるアクセスを制御する仕組みであり、検索結果からの除外を保証するものではありません。
反対に、サイト内検索結果や条件絞り込みなどで大量に生成され、検索エンジンにクロールしてほしくないURL群にはrobots.txtが役立つ場合があります。ただし、noindexを設定するURLをrobots.txtでブロックすると、検索エンジンがnoindexを確認できなくなる点に注意が必要です。
この記事では、robots.txtとnoindexの違い、ページの目的に応じた使い分け、WordPressでの確認点、すでにGoogle検索に表示されているURLへの対処を解説します。
robots.txtとnoindexの違い:検索結果から外すならnoindex
robots.txtとnoindexは、検索エンジンに対する指示でも、制御する段階と目的が異なります。検索結果への掲載を止めるのはnoindex、クロールのアクセスを抑えるのはrobots.txtと整理すると判断しやすくなります。
| 項目 | robots.txt | noindex |
|---|---|---|
| 主な目的 | クローラーのアクセスを抑える | 検索結果への掲載を防ぐ |
| 作用する段階 | クロール前のアクセス制御 | 取得後のインデックス判断 |
| 検索結果からの除外 | 保証しない | 検索エンジンが認識すれば除外対象になる |
| 主な設定場所 | サイト直下のrobots.txt | meta robotsタグ、HTTPヘッダー |
| 向く用途 | 不要なURL群、クロール負荷の抑制 | サンクスページなど検索流入が不要な公開ページ |
Googleはrobots.txtを主にクロールトラフィックの管理に用いるものと案内しています。WebページをGoogle検索から外す方法としては、noindexの設定やアクセス制限が案内されています。
出典:Google Search Central「Robots.txt Introduction and Guide」
robots.txtだけでは検索結果から消せない理由
robots.txtでURLをDisallowしても、検索エンジンがそのURLの存在を知らなくなるわけではありません。外部サイトからリンクされている、XMLサイトマップに記載されている、過去にクロール済みであるといった場合は、URLだけが検索結果に残る可能性があります。
たとえば、robots.txtでブロックしたページに外部リンクがあると、ページ本文を取得できなくても、URLやリンク元のアンカーテキストが検索結果に表示されることがあります。「Disallowを書けば検索結果から消える」とは考えないでください。
検索結果から外したいページは、検索エンジンが取得できる状態でnoindexを返すことが基本です。
出典:Google Search Central「Robots.txt Introduction and Guide」
noindexとrobots.txtを同じURLで併用する注意点
noindexは、検索エンジンがHTML内のmeta robotsタグ、またはHTTPレスポンスヘッダーを取得して初めて確認できます。そのため、対象URLをrobots.txtでDisallowすると、noindexの指示を読めないおそれがあります。
検索結果から除外したいURLにnoindexを設定するなら、少なくともGoogleがnoindexを認識するまではrobots.txtでブロックしないでください。noindexによる除外をSearch Consoleで確認した後も、robots.txtによる追加制御が必要かは個別に検討します。
なお、robots.txtに「noindex」と記述して検索結果から除外する方法は、Googleではサポートされていません。
出典:Google Search Central「Block Search Indexing with noindex」
目的別:robots.txt・noindex・認証の使い分け
設定は「検索結果に出したくないのか」「クロールだけを減らしたいのか」「第三者による閲覧自体を止める必要があるのか」で選びます。非公開情報は認証で保護することが前提です。
- 検索結果に出したくないが、URLを知る人には表示してよい:noindex
- 検索対象ではなく、クロール回数も抑えたい:robots.txtを検討
- 個人情報、会員情報、開発画面などを見せてはいけない:ログイン認証、IP制限、非公開化、削除
- 似たページの評価を代表URLへ集約したい:canonicalやリダイレクトを優先して検討
重複ページの正規化では、検索対象から外すnoindexより、代表URLを示すcanonicalが適することがあります。並び順や計測パラメータだけが異なり、内容がほぼ同じURLでは、公開目的とサイト構造を確認したうえでcanonicalを検討してください。
出典:Google Search Central「How to Specify a Canonical with rel="canonical" and Other Methods」
ページ種類ごとの推奨設定
次の表は一般的な判断例です。最適な設定は、公開目的、ログインの有無、外部リンク、サイト内での役割によって変わります。
| ページ・ファイルの種類 | 主な推奨 | 注意点 |
|---|---|---|
| お問い合わせ完了・購入完了ページ | noindex | 表示は必要でも、通常は検索流入を必要としません。 |
| 会員限定ページ | ログイン認証+必要に応じてnoindex | noindexだけでは直接アクセスを防げません。 |
| WordPress管理画面 | 認証を前提にクロール抑制を検討 | robots.txtはセキュリティ対策ではありません。 |
| サイト内検索結果・絞り込みURL | 構造に応じてrobots.txtまたはnoindex | 大量生成される場合はクロール抑制が有効なことがあります。 |
| 内容が重複する公開ページ | canonical、統合、リダイレクトを優先 | noindexだけでは流入を失う場合があります。 |
| 通常の記事・商品ページ | 原則としてindex可能にする | 誤ったnoindexやDisallowに注意します。 |
| PDF・画像などHTML以外のファイル | X-Robots-Tagを検討 | HTML用のmeta robotsタグは設置できません。 |
公開してはいけない情報はrobots.txtやnoindexで守らない
robots.txtもnoindexもアクセス制限の機能ではありません。robots.txtは対応するクローラーへの指示にすぎず、URLを知る人や指示に従わないボットのアクセスを防げません。noindexを付けたページも、通常はURLへ直接アクセスできます。
個人情報、顧客データ、請求書、テスト環境、社内資料などは、公開URLに置かないことが最も安全です。ログイン認証、VPN、IPアドレス制限、サーバー上からの削除など、目的に合うアクセス制御を実施してください。
出典:Google Search Central「Control the Content You Share on Search」
noindexを正しく設定する方法
noindexの設定場所はページの種類で異なります。HTMLページにはmeta robotsタグ、PDFなどHTML以外のファイルにはX-Robots-Tagを使うのが代表的です。noindex対象は検索エンジンが取得可能な状態にします。
HTMLページはmeta robotsタグで指定する
固定ページ、投稿ページ、カテゴリページなどHTMLで表示されるURLでは、head要素内にmeta robotsタグを出力します。
<meta name="robots" content="noindex">
リンク先の発見や評価を必要以上に止めたくない場合は、noindexのみの指定が基本です。noindex,followと明示することもできますが、followは通常の既定動作であるため、必須ではありません。リンク先も追跡させない特別な事情がある場合に限り、noindex,nofollowを検討します。
設定後は画面表示だけで判断せず、ブラウザのページソースや開発者ツールで、実際のhead内にnoindexが出力されているかを確認してください。テーマ、SEOプラグイン、キャッシュプラグイン、CDNの設定が競合する場合があります。
出典:Google Search Central「Block Search Indexing with noindex」
PDFや画像などHTML以外のファイルはX-Robots-Tagを使う
PDF、画像、動画などにはHTMLのhead要素を置けません。このようなファイルは、Webサーバーが返すHTTPレスポンスヘッダーにX-Robots-Tagを設定します。
X-Robots-Tag: noindex
設定はApacheの.htaccess、Nginxの設定、CDN、アプリケーションのレスポンス設定などで行います。環境により手順が異なるため、対象範囲を確認してから設定することが重要です。拡張子単位の設定では、必要なPDFまで一括でnoindexにしないよう注意してください。
出典:Google Search Central「Block Search Indexing with noindex」
WordPressでnoindexを設定するときの注意点
WordPressで個別ページをnoindexにする方法は、SEOプラグイン、テーマ、独自実装によって異なります。編集画面に「検索結果に表示しない」などの設定があっても、対象ページのHTMLにnoindexが出力されているかを必ず確認してください。
WordPressの「設定」→「表示設定」にある「検索エンジンがサイトをインデックスしないようにする」は、個別ページではなくサイト全体に影響し得る設定です。本番サイトで有効にすると、記事や商品ページも検索結果から外れるおそれがあります。開発環境から本番環境へ移行した後は、設定を見直しましょう。
WordPress.orgは、この設定が検索エンジンにインデックスしないよう求める設定であり、検索エンジンがこの要請に従うかは保証されないと説明しています。非公開にしたい情報には、この設定だけでなく認証を使用してください。
出典:WordPress.org「Settings Reading screen」
robots.txtでクロールを抑える方法と注意点
robots.txtはサイトのルートに置くテキストファイルです。たとえばhttps://example.com/robots.txtで公開し、対応するクローラーがアクセス可能なURLの範囲を判断する際に参照します。必要なURLだけを限定して制御することが大切です。
robots.txtの基本的な記述例
次は、WordPress管理領域のクロールを抑えつつ、Ajax処理で使われるファイルを例外的に許可する記述例です。すべてのWordPressサイトにそのまま適用できるわけではないため、自サイトの構成を確認して使用してください。
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
User-agent: *は全クローラーを対象にする指定です。Disallowにはクロールを避けたいパスを記述し、AllowはDisallow配下で例外的に許可したいURLに使います。
robots.txtを変更したら、シークレットウィンドウなどでrobots.txtへ直接アクセスし、公開サーバー上の内容を確認します。GoogleはSearch Consoleのrobots.txtレポートや、robots.txtライブラリを用いたローカルテストも案内しています。
出典:Google Crawling Infrastructure「Create and Submit a robots.txt File」
robots.txtに書かないほうがよいケース
次の目的だけでrobots.txtを使うことは適切ではありません。
- 検索結果から特定ページを消したい
- サンクスページや会員ページをインデックスさせたくない
- 個人情報や管理用URLを隠したい
- 公開記事や商品ページへの検索流入を維持したい
- 重複URLを正規URLへ集約したい
検索結果から外すならnoindex、機密情報を守るなら認証または削除、重複を集約するならcanonicalやリダイレクトというように、目的に合う手段を選びます。robots.txtはURLを隠すためのファイルではありません。
出典:Google Search Central「Google Search Technical Requirements」
すでに検索結果に出ているURLを削除する手順
すでにGoogleにインデックスされているURLは、先に恒久対応を実施し、その後に再クロールを待つのが基本です。削除ツールだけでは恒久削除になりません。
ページの状態を目的に応じて変更する
検索結果から消したい理由に応じて、ページ自体の状態を変えます。ページを残して閲覧可能にしたいならnoindex、完全に廃止したなら404または410、非公開情報ならログイン認証やパスワード保護が候補です。
- サンクスページなどを残す:noindexを設定し、robots.txtではブロックしない
- 不要になったページを廃止する:適切な404または410を返す
- 権限のある人だけに見せる:ログイン認証やパスワード保護を行う
- 移転先がある:関連性の高い移転先へのリダイレクトを検討する
noindexを追加しても、Googleが次回クロールしてタグを確認するまでは検索結果に残ることがあります。反映時期はURLの重要性やクロール頻度などで変わるため、日数を一律に断定することはできません。
出典:Google Search Central「Block Search Indexing with noindex」
Search Consoleの削除ツールは緊急時の一時的な非表示に使う
個人情報が誤って表示されたなど、Google検索で緊急に一時非表示にしたい場合は、Google Search Consoleの削除ツールを使えます。ただし、この機能による非表示は通常約6か月です。
削除ツールを使う場合も、noindex、404・410、認証などの恒久対応を並行してください。恒久対応をしないまま期限が切れると、URLが再び検索結果に表示される可能性があります。削除ツールはGoogle検索だけを対象にします。
出典:Google Search Console Help「Removals and SafeSearch reports tool」
設定後にGoogle Search Consoleで確認するポイント
設定内容が正しくても、キャッシュ、リダイレクト、robots.txt、HTTPステータス、プラグインの競合などで意図どおりに反映されないことがあります。実装後は、URL検査でGoogleが取得した状態を確認します。
URL検査でnoindexとクロール可否を確認する
Google Search ConsoleのURL検査では、対象URLがGoogleにクロール可能か、インデックス登録に影響する問題がないかを確認できます。noindexを設定したURLでは、Googleが取得したHTMLまたはレスポンスヘッダーにnoindexが含まれているかを確認してください。
意図せずrobots.txtでブロックされている場合、Googleはnoindexを認識できません。対象URLのほか、正規URL、httpとhttps、wwwの有無、末尾スラッシュ、パラメータ付きURLも区別して確認すると、設定漏れを防ぎやすくなります。
サイト全体では、ページのインデックス登録に関するレポートを確認し、「noindexタグによって除外されました」などの状態が想定どおりかを見ます。公開すべき重要ページがnoindexで除外されていないかも確認しましょう。
出典:Google Search Central「Block Search Indexing with noindex」
反映時期を決め打ちせず再クロール状況を見る
変更後の反映時期は、サイトやURLごとに異なります。Googleは変更したページのクロールに数日から数週間かかることがあると案内しており、noindexも再クロールされるまで反映を待つ必要があります。
急ぎでなければ、恒久対応を設定したうえで、URL検査とインデックス状況を定期的に確認します。URL検査からインデックス登録をリクエストすることもできますが、即時反映を保証する機能ではありません。
出典:Google Search Central「Ask Google to Recrawl Your Website」
robots.txtとnoindexを使い分ける際によくある質問
設定前によくある疑問を、実務上の判断に必要な範囲で補足します。
robots.txtだけで検索結果から消せますか?
いいえ、robots.txtだけでは検索結果からの削除を保証できません。クロールされないURLでも、外部リンクなどを手掛かりにURLだけが表示される可能性があります。検索結果から外す目的なら、クローラーが取得できる状態でnoindexを設定してください。
noindexとDisallowは併用できますか?
同じURLでnoindexを認識させたい場合、Disallowとの併用は避けるべきです。robots.txtでクロールを止めると、Googleはmeta robotsタグやX-Robots-Tagを確認できません。まずnoindexの反映を確認し、追加のクロール制御が必要かを判断してください。
noindexを設定したのに検索結果に残るのはなぜですか?
Googleがまだ再クロールしていない、robots.txtでブロックされている、noindexがHTMLやHTTPヘッダーに出力されていない、別URLがインデックスされている、といった原因が考えられます。Search ConsoleのURL検査で、Googleが取得したURLとnoindexの検出状況を確認します。
まとめ:検索結果の非表示はnoindex、クロール抑制はrobots.txt
robots.txtとnoindexを混同しないためには、目的を分けることが大切です。検索結果に出したくないURLはnoindex、クロールを減らしたいURL群はrobots.txt、第三者に見せてはいけない情報は認証や非公開化で対応します。
特に、noindexを設定したURLをrobots.txtでDisallowすると、検索エンジンがnoindexを確認できない場合があります。検索結果からの除外を優先するなら、対象URLをクロール可能な状態に保ち、noindexの認識をSearch Consoleで確認してください。
設定後は、重要な記事・商品ページまで誤ってnoindexやDisallowの対象にしていないかを確認しましょう。ページごとの目的に合わせて設定を分けることが、検索流入を守りながら不要なURLを管理する基本です。