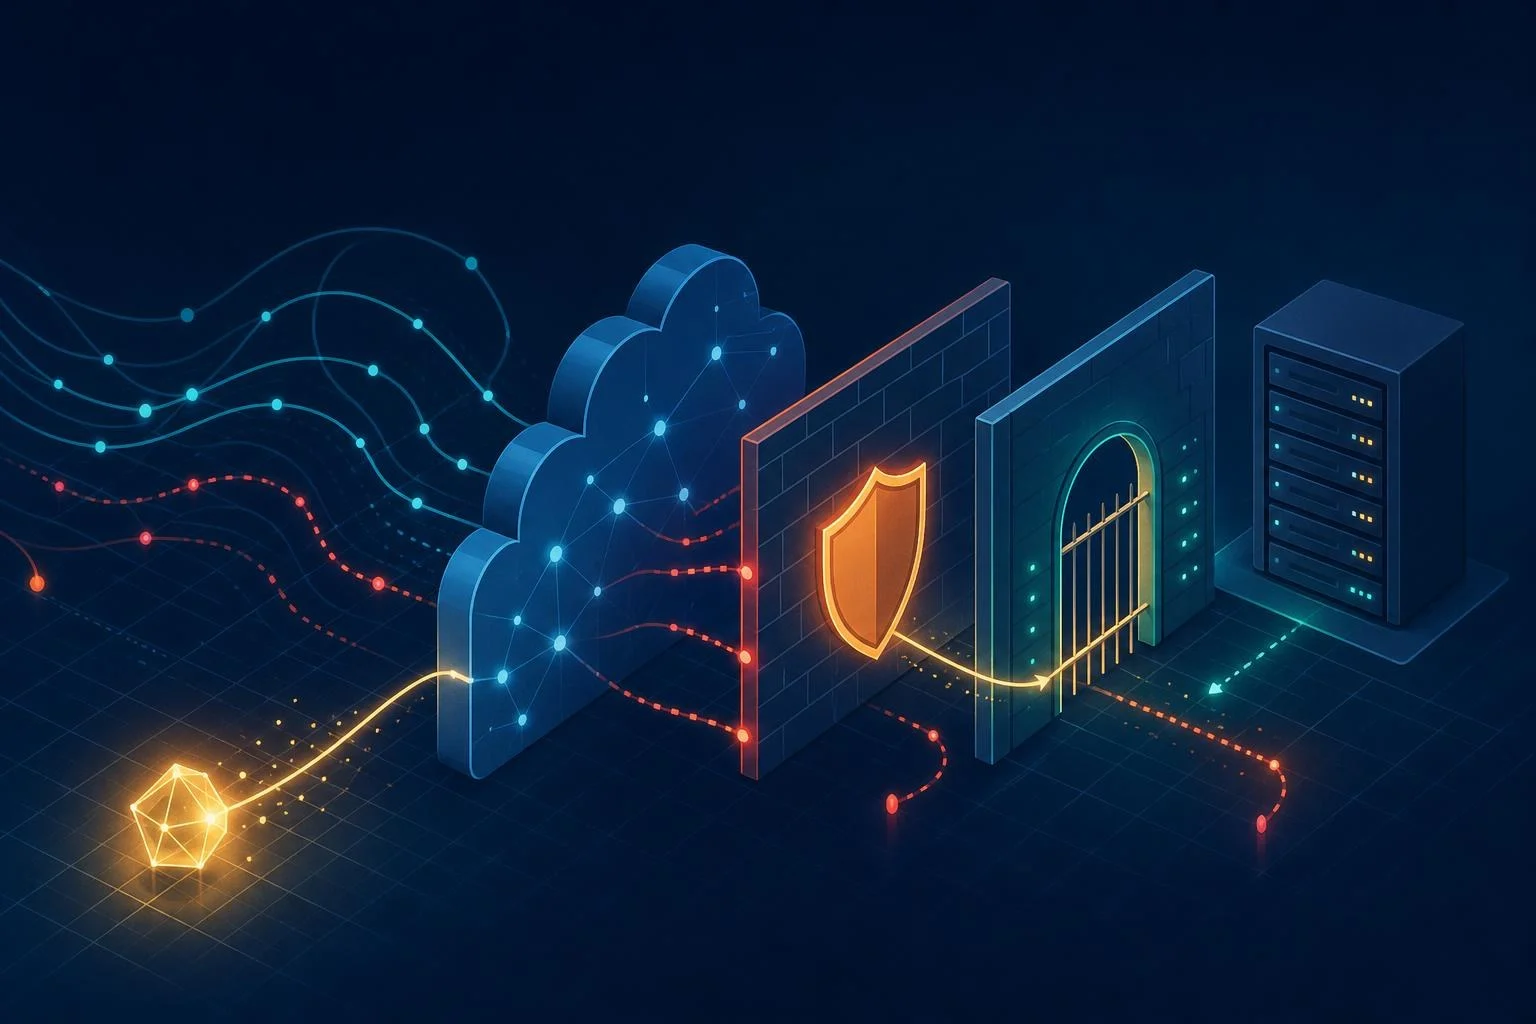
OAI-SearchBotがクロールできない場合、robots.txtで許可しているだけでは解決しないことがあります。CDN、WAF、Bot対策、レート制限、IP・国制限、Basic認証、オリジンサーバーのいずれかでリクエストが拒否されている可能性があるためです。
最短の解決策は、例外ルールを推測で増やすことではなく、どの層がどの応答を返したかをログで特定することです。403、429、5xxなどのHTTPステータスと、CDN・WAFのセキュリティイベント、オリジンサーバーのログを同じ時刻で突き合わせてください。
この記事では、OAI-SearchBotを必要な公開ページにだけ安全に許可するために、原因の切り分け順、CDN・WAFでの調査方法、IP許可の注意点、設定変更後の検証方法を解説します。
OAI-SearchBotがクロールできないときは、robots.txt以外の遮断をログで切り分ける
OAI-SearchBotは、OpenAIがChatGPTの検索機能に関連して案内しているWebクローラーです。robots.txtでOAI-SearchBotを拒否していればクロールは妨げられますが、許可していてもCDN、WAF、認証、レート制限などがHTTPリクエストを拒否すれば、クローラーはページを取得できません。
「robots.txtをAllowにしたのに来ない」「アクセスログに記録があるのに403になる」といった場合は、公開設定からオリジンサーバーまでを順に確認します。なお、OAI-SearchBotとGPTBotは用途が異なるため、robots.txtの指定もそれぞれ独立して確認する必要があります。
出典:OpenAI Developers「Overview of OpenAI Crawlers」
最初に確認する項目と切り分けの順番
設定を緩める前に、公開可否と拒否地点を確認してください。 次の順で確認すると、不要なIP許可やWAF無効化を避けながら原因を絞り込めます。
| 確認順 | 主な確認対象 | 確認場所 | 問題があった場合の対応 |
|---|---|---|---|
| 1 | 公開状態、DNS、TLS、リダイレクト | ブラウザ、HTTPヘッダー、監視ログ | 公開URLを正常なHTTPSページへ統一する |
| 2 | robots.txt、meta robots、X-Robots-Tag | /robots.txt、HTML、レスポンスヘッダー | 対象ホスト・パスの拒否設定を見直す |
| 3 | HTTP応答コード | CDNログ、アクセスログ、エラーログ | 401・403・429・5xxの発生層を特定する |
| 4 | CDN・WAF・Bot対策 | セキュリティイベント、Firewall・WAFログ | 該当ルールだけを限定的に調整する |
| 5 | IP・国・ASN制限、認証 | アクセス制御、認証、ネットワーク設定 | 公開ページだけに必要最小限の例外を作る |
| 6 | オリジンサーバー・CMS・プラグイン | Webサーバー設定、管理画面、アプリログ | Bot拒否、過負荷、タイムアウトを修正する |
CDNを利用しているサイトでは、リクエストがオリジンサーバーに届かず、オリジンのアクセスログに記録が残らないことがあります。この場合は、CDNまたはWAFなど、オリジン到達前の経路で停止している可能性を調べます。
OAI-SearchBotを許可していてもクロールできない主な原因
クロール失敗の原因は単一とは限りません。robots.txtは許可済みでも、CDNのBot対策がチャレンジを返し、さらにオリジン側のセキュリティプラグインが拒否している構成もあり得ます。まずは自サイトに該当する原因を確認してください。
robots.txt、クロール対象外の指定、公開状態に問題がある
robots.txtでは、対象のホスト名とパスでOAI-SearchBotを許可しているかを確認します。wwwあり・なし、サブドメイン、別言語用ドメインは、原則としてホストごとにrobots.txtを確認します。WordPressの設定やSEOプラグイン、配信基盤が付与するmeta robots・X-Robots-Tagも確認対象です。
公開ページをクロール対象にしたい場合のrobots.txt記述例は、次のとおりです。
User-agent: OAI-SearchBot
Allow: /
ただし、この例はサイト全体を対象にしてよい場合だけに使います。会員ページ、管理画面、注文完了ページ、ステージング環境までクロールさせる必要はありません。なお、noindexは一般に検索インデックスへの登録を制御する指定であり、HTTPリクエストそのものを拒否するものではありません。クロール可否の調査では、robots.txt、認証、HTTP応答を分けて確認します。
OpenAIは、robots.txtの変更がシステムに反映されるまで、おおむね24時間かかる場合があると案内しています。設定変更直後に何度もルールを変えるのではなく、反映時間も考慮してログを確認してください。
出典:OpenAI Developers「Overview of OpenAI Crawlers」
CDN・WAF・Bot対策・レート制限で拒否されている
CDNやWAFは、不正アクセス、DDoS、脆弱性攻撃、過剰な自動アクセスを防ぐため、機械的なアクセスをブロックまたはチャレンジすることがあります。OAI-SearchBotも自動アクセスであるため、設定次第では正規クローラーであっても検知対象になる可能性があります。
確認対象は、WAFマネージドルール、カスタムルール、Bot管理、JavaScriptチャレンジ、CAPTCHA、User-Agentブロック、レート制限です。原因調査のためにWAF全体を無効化することは避けてください。 攻撃防御まで失われるため、ログで該当ルールを確認し、対象ホスト・対象パスに限定して例外を作る方が安全です。
たとえばCloudflareでは、カスタムルール、レート制限、マネージドルール、Bot対策機能が別の段階で評価されます。ブロックやチャレンジのような終了アクションが実行されると、後続の評価は行われません。利用中のCDN・WAFについても、ルールの評価順と例外設定の仕様を公式ドキュメントで確認してください。
出典:Cloudflare Developers「Security features interoperability」
IP・国・ASN制限、認証、ネットワーク制限で到達できない
IP許可・拒否リスト、国別ブロック、ASN制限、Basic認証、VPN必須、社内IP限定も見落としやすい原因です。これらのアクセス制御はrobots.txtの指示とは別に機能するため、クローラーの通信を止めることがあります。
「日本からのアクセスのみ許可」「社内VPN経由だけ許可」「特定のクラウド事業者ASNを拒否」といった設定は、OpenAIのクローラーがページへ到達できない原因になり得ます。CDNだけでなく、ロードバランサー、クラウドのセキュリティグループ、ホスティング会社の防御機能、Webサーバー設定も確認してください。
一方で、社内限定サイト、ステージング、会員専用領域、顧客情報を扱う画面をクローラーのために公開するべきではありません。非公開領域を開放せず公開コンテンツを分離することが基本です。
オリジンサーバーやアプリケーションで拒否・障害が起きている
CDN・WAFでブロック記録が見つからない場合は、オリジンサーバー側を調べます。ApacheやNginxのアクセスログ・エラーログ、ホスティングのWebアクセス制限、WordPressのセキュリティプラグイン、アプリケーションファイアウォール、PHPやデータベースの過負荷が主な確認対象です。
オリジン側では、User-Agent文字列による拒否、アクセス頻度で遮断するプラグイン、リクエストヘッダーを厳格に検査するアプリケーション、長い応答時間によるタイムアウトなどが問題になることがあります。CDN経由の構成では、オリジンサーバーが実際のクライアントIPではなくCDNのIPだけを見ているケースもあるため、IP取得設定も確認します。
CDN・WAFでOAI-SearchBotの遮断箇所を確認する方法
CDN・WAFの画面操作は製品やプランで異なりますが、調査の観点は共通です。「いつ」「どのURLへ」「どの送信元から」「どのルールによって」「どのアクションが実行されたか」を確認し、推測でルールを変更しないことが重要です。
セキュリティイベントから対象リクエストと拒否ルールを特定する
まず、問題が起きた時刻を軸にログを絞り込みます。 CDN・WAFのセキュリティイベントで、次の項目を可能な範囲で確認してください。
- 日時とタイムゾーン
- ホスト名、リクエストURL、パス、クエリ文字列
- HTTPステータス、実行アクション、ルールID、サービス名
- 送信元IP、国、ASN
- User-Agent
- リクエストID、Ray IDなどの追跡用ID
CloudflareのSecurity Eventsでは、アクション、ホスト、国、IPアドレス、User-Agent、パス、ASNなどを使ってイベントを確認できます。Bot関連の問題では、User-Agentやアクションを条件に、ブロック、Managed Challenge、レート制限などを絞り込むと調査しやすくなります。ただし、ログの保持期間や表示条件は契約内容・設定により異なるため、イベントが見つからないことだけでCDNが無関係とは断定できません。
出典:Cloudflare Developers「Security Events」
Bot管理・WAF・レート制限・許可拒否ルールの優先順位を確認する
同じURLに複数の防御ルールが設定されている場合、どのルールが先に評価されるかで結果が変わります。先にカスタムルールがBlockを返していれば、後段の許可条件を変更しても改善しないことがあります。
カスタムの拒否・チャレンジルール、IP・国・ASN制限、Bot対策、レート制限、WAFマネージドルール、User-Agentブロックを確認対象にします。ただし、実際の評価順はサービスや設定方式で異なります。管理画面の一覧だけで判断せず、イベントログのルールIDと実行アクションを根拠に判断します。
Cloudflareのレート制限では、条件に一致したリクエストが設定回数を超えると、ブロックやチャレンジなどの緩和アクションが実行されます。公開ページ全体を例外にするのではなく、問題のあるホスト・パス・条件をできるだけ小さく設定してください。
出典:Cloudflare Developers「Rate limiting rules」
CDNを通過してオリジンまで届いているかを確認する
CDN・WAFのイベントに拒否がない場合は、オリジンのアクセスログを同時刻で検索します。CDN側のリクエストID、URL、時刻、送信元情報と、Nginx・Apache・アプリケーションのログを突き合わせてください。
オリジンログに該当リクエストがなければ、CDN、DNS、TLS、ネットワーク経路など、オリジン手前で停止している可能性があります。到達記録があり、オリジンで401、403、429、500、502、503、504などを返しているなら、Webサーバー、アプリケーション、上流API、データベース、タイムアウト設定を優先して確認します。
HTTPステータスコードとアクセスログから原因を絞り込む
HTTPステータスは原因そのものではなく、次に確認する場所を絞る手掛かりです。同じ403でも、CDNのFirewallルール、Basic認証、WordPressプラグイン、オリジンのアクセス制限など、発生源は異なります。
401・403・404・429・5xxで確認すべきこと
ステータスコードとイベントログを必ずセットで確認します。 次の表を初動の目安として使ってください。
| ステータス | 主な意味 | 優先して確認する場所 | 主な対応 |
|---|---|---|---|
| 401 | 認証が必要 | Basic認証、ログイン必須設定、会員制御 | 公開ページを認証外へ分離する |
| 403 | アクセス拒否 | WAF、Bot対策、IP・国制限、Webサーバー設定 | 拒否したルールを特定して限定的に見直す |
| 404 | URLが存在しない | リダイレクト、正規URL、サイトマップ、パーマリンク | 到達先URLとリンク構造を修正する |
| 429 | リクエスト過多 | CDN・WAFのレート制限、アプリ側の制限 | 対象パス・閾値・緩和時間を確認する |
| 500・502・503・504 | サーバーまたは上流の障害 | オリジンログ、PHP・DB・上流API、タイムアウト | 障害・負荷・接続設定を解消する |
OpenAIも、クローラーがアクセスできない場合は、403などの応答、WAF・CDNログ、Bot緩和イベント、認証、地理的制限、レート制限を確認するよう案内しています。429が発生しているときは、短時間のアクセス集中だけでなく、レート制限ルールの集計単位と緩和時間も確認してください。
出典:OpenAI Help Center「Advertiser Guidance for Allowing OpenAI Web Crawlers」
ログ調査で記録する項目と突合の手順
一度の設定変更で解決しない場合に備え、変更前後の事実を記録します。記録項目は、変更日時、変更したルール名、対象ホスト・パス、許可または除外の条件、HTTPステータス、CDN・WAFイベントID、オリジンログの該当行、確認者です。
調査は、CDN・WAFログで拒否時刻を確認し、次に同時刻のオリジンアクセスログとエラーログを検索する流れが基本です。ログを外部ベンダーや社内の別部署へ共有する際は、Cookie、Authorizationヘッダー、メールアドレス、IPアドレス、注文番号などの機密情報・個人情報が含まれていないか確認し、必要に応じてマスキングしてください。
正規のOAI-SearchBotだけを安全に許可する設計
クローラー許可では、アクセス可能にするだけでなく、公開不要な画面を露出させず、偽装Botに広い例外を与えず、将来のIP情報やCDN設定の変更にも対応できる運用が必要です。
OpenAI公式情報でUser-Agent・IP情報・検証方法を確認する
OAI-SearchBotのUser-Agent、バージョン表記、送信元IP範囲は変更され得ます。固定のIPアドレス一覧を手作業で転記し続けるのではなく、設定時点でOpenAIが公開する情報を確認してください。
OpenAIはOAI-SearchBotの用途、User-Agent例、robots.txt取得時に付く場合がある識別子、公開IPアドレスの参照先を案内しています。IP許可が必要な環境では、OpenAI公式のsearchbot.jsonを参照し、利用中のCDN・WAF・ファイアウォールがCIDR形式の更新に対応できるかを確認します。
出典:OpenAI Developers「Overview of OpenAI Crawlers」
出典:OpenAI「OAI-SearchBot published IP addresses」
User-Agentだけの無条件許可や広すぎるIP許可を避ける
User-Agent文字列はクライアント側で任意に名乗れるため、「OAI-SearchBotを含むUser-Agentならサイト全体を無条件許可する」という設計は安全とはいえません。管理画面、API、ログイン、購入手続き、検索フォームまで広く除外する必要はありません。
許可ルールを作るなら、対象を公開用ホスト名と必要なパスに限定し、原則としてGET・HEADなど閲覧用メソッドに限定します。OpenAI公式の公開IP範囲を利用できる環境では、更新方法を決めたうえで併用します。CDNが検証済みBotの判定を提供している場合も、対象Botと判定仕様を確認してください。
OpenAIも、短期間のログ観測だけでIPを判断せず、User-Agent、公開IP範囲、robots.txt、利用中プロバイダーのBot検証機能などを組み合わせて確認するよう案内しています。IP許可には更新手順と定期確認を組み込みます。
出典:OpenAI Help Center「Advertiser Guidance for Allowing OpenAI Web Crawlers」
社内限定・ステージング・会員専用コンテンツは公開対象から分離する
社内ポータル、検証環境、会員専用ページ、顧客別ダッシュボードは、OAI-SearchBotを許可するためにBasic認証やVPN制限を解除してはいけません。robots.txtはアクセス制御の代替ではなく、公開済みコンテンツに対するクローラーへの指示です。
公開したい記事や商品ページがある場合は、公開用ドメインまたは公開用パスに集約し、非公開機能は別ホスト・別パス・別認証で保護します。公開サイト内に混在させる場合も、管理画面や個人情報を含むURLがリンク、サイトマップ、内部検索結果に露出しないように設計してください。
設定変更後の確認と再クロールを待つ際の注意点
設定を変更した後は、ルールを保存しただけでは完了ではありません。変更した対象ホスト・パスで拒否が解消していることを、CDN・WAFとオリジンの両方で確認します。
変更内容を記録し、同じ条件でHTTP応答とイベントログを確認する
確認対象は、変更前に失敗していたURLと同じ条件にそろえます。 403が出ていた記事URLについて、CDN・WAFイベントでBlockやManaged Challengeが発生しなくなったか、オリジンログに到達し200系または意図したリダイレクトが記録されるかを確認してください。
併せて、robots.txtが200で取得できること、OAI-SearchBotに対するDisallowが意図せず残っていないこと、対象ページがログインなしで表示できることを確認します。meta robotsやX-Robots-Tagについては、サイトの公開・インデックス方針と矛盾していないかを見直します。
再クロールの時期は保証されないため、公開状態を継続して監視する
アクセス制限を修正しても、OAI-SearchBotが直ちに再訪問するとは限りません。また、クロール可能な状態になったことと、ChatGPTの検索結果にいつ・どのように表示されるかは別の問題です。設定を何度も全面緩和して再訪問を促そうとしないでください。
robots.txtの変更については、OpenAIがシステム調整におおむね24時間かかる場合があると説明しています。変更後は一定期間、HTTP応答、CDN・WAFイベント、オリジンログを確認し、同じ拒否が再発していないかを監視します。
出典:OpenAI Developers「Overview of OpenAI Crawlers」
OAI-SearchBotのクロール許可に関するよくある質問
設定判断で迷いやすい点を、本文と重複しない実務上の注意点に絞って回答します。
robots.txtでAllowにすれば必ずクロールされますか?
いいえ、robots.txtの許可は必要条件の一つにすぎません。 CDN・WAF・認証・IP制限・レート制限・サーバー障害などでページを取得できない場合があります。アクセス可能な状態でも、クローラー側の巡回タイミングや処理結果は保証されません。
OpenAIのIPアドレスを固定許可リストに登録してよいですか?
IP許可が必要なサイト構成であり、公式情報の更新を継続して反映できる場合に限り、必要最小限で登録します。過去ログで見つけた単一IPを恒久的に許可するのではなく、OpenAIが公開するOAI-SearchBotのIP情報を確認し、CIDR範囲の更新手順と確認担当を決めてください。
403と429では何を優先して確認すべきですか?
403では、WAF、Bot対策、IP・国制限、Basic認証、Webサーバーのアクセス拒否を優先します。429では、CDN・WAFとアプリケーション側のレート制限、集計単位、閾値、緩和時間を確認します。どちらもステータスだけで断定せず、同時刻のイベントログとオリジンログを突き合わせることが重要です。
まとめ:遮断した層を特定してから、必要最小限の例外を設定する
OAI-SearchBotがクロールできない場合は、robots.txtだけを見直して終わりにせず、公開状態、HTTP応答、CDN、WAF、Bot対策、レート制限、IP・国・ASN制限、認証、オリジンサーバーの順に確認してください。
先にログで遮断層を特定し、その場所だけを調整することが、安全かつ再現性の高い進め方です。User-Agentだけの無条件許可、WAFの全面停止、社内・会員・ステージング環境の公開は避け、公開コンテンツのホスト名・パス・メソッドに限定した例外設計を行いましょう。
OAI-SearchBotの識別情報やIP範囲、CDN・WAFの機能名・評価順は変更される可能性があります。設定時にはOpenAIと利用中サービスの公式ドキュメントを確認し、変更内容と検証結果を記録して運用してください。