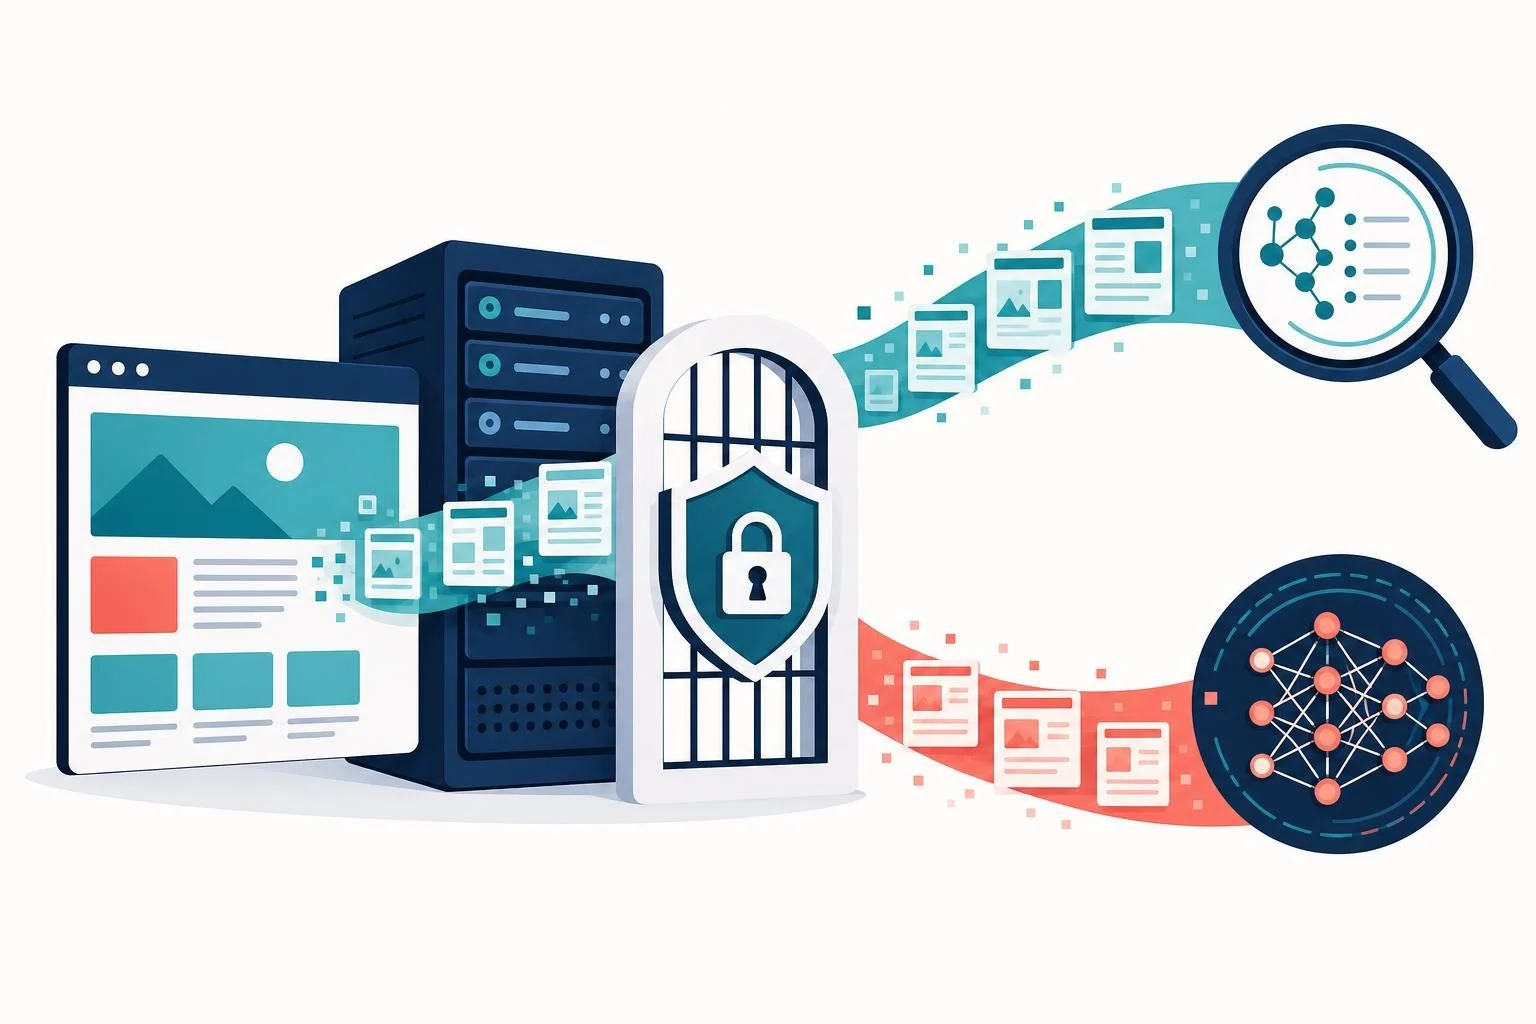
AI検索用クローラーとAI学習用クローラーは、どちらも公開Webページを取得しますが、取得後の主な利用目的が異なるため、同じ方針で一律に扱うべきではありません。AI検索で自社サイトを見つけてもらいたいか、将来のAIモデルの訓練にコンテンツが使われることを許容するかを、分けて判断することが重要です。
たとえば、最新の商品情報、店舗情報、企業の公式発表を届けたいサイトでは、AI検索向けの取得を許可する選択肢があります。一方、独自ノウハウ、有料記事、権利処理が限定された画像・資料などは、AI学習向けの取得を拒否する判断が考えられます。
ただし、クローラー名、利用目的、robots.txtへの対応範囲は提供事業者によって異なり、変更されることもあります。この記事の記述例は考え方を理解するためのものです。実際に設定する際は、必ず対象事業者の公式ドキュメントで最新のユーザーエージェント名と仕様を確認してください。
まず決めるべきは「AI検索で見つけられたいか」と「AI学習を許容するか」
最初に決めるべきことは、AIにクロールされるかどうかではなく、どの用途の取得を、どのコンテンツまで許可するかです。AI検索での引用・リンク・認知獲得を期待することと、モデル学習への利用を許容することは、必ずしも同じではありません。
| サイト・コンテンツの性質 | AI検索用クローラー | AI学習用クローラー | 判断の考え方 |
|---|---|---|---|
| 企業メディア・採用サイト・公式発表 | 許可を検討 | 方針に応じて判断 | 認知、問い合わせ、最新情報への導線を重視する場合は、検索経由の発見を優先します。 |
| ECサイト・店舗サイト・商品ページ | 許可を検討 | 商品情報の性質に応じて判断 | 在庫・価格・営業時間などの最新情報を参照してほしい場合があります。ただし、仕入れ条件など非公開情報は公開URLに置かないことが前提です。 |
| 独自ノウハウが主資産のオウンドメディア | 許可を検討 | 拒否を検討 | 検索での露出は得たい一方、将来の訓練データ利用には慎重という方針を取りやすい類型です。 |
| 有料記事・会員限定コンテンツ | 公開範囲のみ許可 | 原則として慎重に判断 | robots.txtではなく、ログイン認証や決済後のアクセス制御を中心に設計します。 |
| 写真・イラスト・PDF・素材配布 | 用途とライセンスを確認 | 慎重に判断 | 第三者の著作物、肖像、再利用条件が含まれる場合は、権利処理を優先します。 |
許可範囲を決めるための6つの判断軸
許可・拒否を決める際は、次の6点をサイト単位、必要に応じてディレクトリ単位で確認します。特に、公開しているから自由な学習利用まで問題ない、とは限りません。
- AI検索からの発見を望むか:回答内の参照、リンク、ブランド認知、来訪につながる可能性を重視するかを考えます。
- モデル学習への許容度:将来の基盤モデルの訓練・改善に使われることを、事業方針として許容できるかを決めます。
- 権利・契約上の制約:著作権、肖像権、個人情報、秘密保持、取引先との契約、素材ライセンスを確認します。
- 競争優位性:独自の手順、価格戦略、データベース、専門家の知見などが事業価値の中心かを見極めます。
- 更新頻度と鮮度:営業時間、価格、在庫、法令対応など、最新情報として参照されるメリットが大きいかを考えます。
- 計測・運用体制:アクセスログ、紹介元、エラー、設定変更を確認し、問題があれば戻せる体制があるかを確認します。
全面許可・全面拒否を急がないための基本方針
AIクローラーへの対応では、通常検索用のクローラーまで止めないことが実務上の重要な注意点です。AI学習用のボットを拒否したいだけなら、既存の「User-agent: *」を全面拒否に変更するのではなく、対象ボットだけに個別ルールを追加する方法を先に検討します。
Googleのrobots.txtの解釈では、特定のユーザーエージェントごとにルールを記述できます。また、特定ボット向けのグループと「User-agent: *」のグループは単純に合算されないため、既存の記述を理解せずに追加すると意図しない制御になることがあります。
出典:Google for Developers「How Google Interprets the robots.txt Specification」
AI検索用クローラーとAI学習用クローラーの違い
両者の違いは、Webページを取得する行為そのものではなく、取得した情報を主に何に使うかにあります。ただし、実際のサービスでは検索、回答生成、グラウンディング、モデル改善などが重なり得るため、単純な二分類だけで判断せず、提供元の説明を確認してください。
| 観点 | AI検索用クローラー | AI学習用クローラー |
|---|---|---|
| 主な目的 | 検索結果、回答生成、引用候補、最新情報の参照 | 将来の基盤モデルや関連モデルの訓練・改善 |
| 情報の鮮度 | 更新されたページを参照する価値が比較的高い | 公開直後の情報が直ちに利用者へ届くとは限らない |
| サイト運営者の期待 | リンク、引用、認知、紹介流入の可能性 | 直接の送客や掲載を期待しにくい |
| 主な懸念 | 要約だけで読了される、流入が計測しにくい、誤った要約 | 独自コンテンツの訓練利用、競争上の懸念、権利処理 |
| 設定の考え方 | 公開情報・最新情報を中心に許可を検討 | 資産性や権利条件を踏まえて個別に判断 |
AI検索用クローラーは回答・検索結果で最新情報を参照するためのもの
AI検索用クローラーは、公開ページを発見し、検索結果やAI回答で参照・要約・リンクするために使われるものです。たとえばOpenAIは、ChatGPT検索結果内でコンテンツを要約・スニペット表示するためには、OAI-SearchBotをブロックしないよう案内しています。
許可してもAI回答への掲載や流入は保証されません。検索サービス側は質問との関連性、情報の信頼性、鮮度、ページの利用可否などを総合的に判断します。AI検索に表示されることだけを目的に内容の薄いページを増やすのではなく、一次情報、更新日、責任主体、問い合わせ先を明確にしたページを整備することが基本です。
出典:OpenAI Help Center「Publishers and Developers – FAQ」
AI学習用クローラーは将来のモデル訓練・改善を主目的とするもの
AI学習用クローラーは、公開コンテンツを将来のAIモデルの訓練や改善に利用する目的で取得するものです。サイト運営者にとっては、検索経由の送客をすぐに期待しにくい一方で、独自性の高い記事・データ・表現が収集対象になることへの懸念が判断材料になります。
OpenAIは、学習候補から除外したいサイトやページについて、GPTBotをrobots.txtで拒否するよう案内しています。ただし、robots.txtの変更だけで、過去に取得・利用されたデータを遡って消去したり、第三者経由での利用まで防いだりできる仕組みではありません。
出典:OpenAI Help Center「Publishers and Developers – FAQ」
従来の検索エンジンクローラーとは何が違うのか
GooglebotやBingbotなど、従来の検索エンジンクローラーは、主に検索インデックスを作り、検索結果にページを表示するために利用されます。AI関連クローラーを拒否する設定と、通常のSEOで必要な検索クローラーを拒否する設定は、原則として別の操作です。
ただし、GoogleのGoogle-Extendedは単純な「学習専用ボット」ではありません。GoogleはGoogle-Extendedを、将来のGeminiモデルの訓練に加え、Gemini AppsやVertex AIにおけるグラウンディングの利用可否を管理するトークンとして説明しています。Google検索への掲載やGoogle検索のランキングには影響しないとされていますが、Geminiでの参照も含めて制御対象となるため、検索用だけを許可したい場合は影響範囲を理解して判断する必要があります。
出典:Google for Developers「Google’s common crawlers」
代表的なクローラーは公式情報で用途と指定名を確認する
クローラー名は似ていても役割が異なることがあります。名前だけで用途を決めつけず、公式説明とrobots.txt用の指定名を確認することが必要です。
| 提供元・クローラー | 公式に確認できる主な位置づけ | 設定時の注意 |
|---|---|---|
| OpenAI:OAI-SearchBot | ChatGPT検索での発見、要約、スニペット表示に関係するクローラー | 許可しても掲載・引用・流入は保証されません。 |
| OpenAI:GPTBot | 学習候補から除外したいサイト・ページを指定する対象 | 拒否は今後のクロール方針に関する意思表示であり、過去の利用を遡及的に消すものではありません。 |
| Google:Google-Extended | Geminiの将来モデル訓練とグラウンディングの利用可否を管理するトークン | Google検索の掲載・順位には影響しないとされていますが、Geminiでの参照にも関係します。 |
| Perplexity:PerplexityBot | 検索結果でサイトを表示・リンクするためのクローラー | Perplexityは、同ボットを基盤モデルの事前学習には使わないと説明しています。 |
OpenAIの検索・学習に関係するクローラーを確認する
OpenAIでは、OAI-SearchBotとGPTBotを分けて案内しています。そのため、OpenAI経由の検索で公開情報を見つけてもらう可能性は残しつつ、将来の学習候補からは外したい、という方針を検討できます。
もっとも、これはOpenAIが公開しているボットごとの区分に基づく判断です。広告確認など別目的のボットもあり得るため、サイトの広告出稿、API連携、外部サービスの利用状況によっては、関係するクローラーを追加で確認してください。
出典:OpenAI Help Center「Publishers and Developers – FAQ」
Google・Microsoftなどは通常検索とAI機能の関係を個別に確認する
Googleでは、通常のGoogle検索向けクローラーとGoogle-Extendedは別に管理されています。一方で、AI機能における情報利用の範囲は、学習と検索インデックスに基づくグラウンディングが重なることがあります。通常検索を残しても、AI機能での扱いは個別に確認が必要です。
Microsoftやその他の提供事業者についても、ボット名、検証方法、robots.txt対応、検索・回答・学習の関係は個別に異なります。未確認のユーザーエージェント名をブログ記事やSNSから転記して設定するのではなく、公式ドキュメントで確認できたものだけを対象にしてください。
出典:Google for Developers「Crawling infrastructure」
robots.txtでAIクローラーごとの許可・拒否を設定する手順
robots.txtは、サイトのルートに置くテキストファイルで、クローラーごとにクロール可能なURL範囲を示します。設定は、既存の設定を確認してから、対象ボットだけを追加する順番で進めると事故を減らせます。
- ブラウザで「https://自社ドメイン/robots.txt」を開き、現在の内容を保存します。
- Googlebotなど、通常の検索流入に必要な既存ルールを確認します。
- AI検索用とAI学習用について、許可・拒否の方針を決めます。
- 対象事業者の公式ページで、robots.txtに記述する正確なユーザーエージェント名を確認します。
- ステージング環境で可能な範囲の確認を行い、本番へ反映します。
- 公開後にrobots.txtの配信内容、サーバーログ、検索状況、エラーを確認します。
設定前に既存のrobots.txtと影響範囲を確認する
robots.txtは「https://example.com/robots.txt」のように、ドメイン直下に置かれます。サブドメインがある場合は、原則としてサブドメインごとに確認が必要です。また、HTTPとHTTPS、ポート番号が異なれば適用範囲も別になります。
特に「User-agent: *」に対して「Disallow: /」を記述すると、対応する多くのクローラーがサイト全体を取得できなくなります。AI学習用だけを止める目的で、この包括的なルールを追加・変更すると、Googlebotなどの通常検索クローラーにも影響するおそれがあります。
出典:Google for Developers「How Google Interprets the robots.txt Specification」
AI検索用は許可し、AI学習用は拒否する記述例
以下は、OpenAIのOAI-SearchBotにはサイト全体を許可し、GPTBotにはサイト全体を拒否する場合の例です。実装前に、既存のrobots.txtと競合しないかを確認してください。
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /Google-Extendedを拒否する場合は、次のように別グループで記述します。ただし前述のとおり、Google-Extendedは将来のGeminiモデル訓練だけでなく、Geminiにおけるグラウンディングにも関係します。Google検索への影響だけを見て追加しないことが重要です。
User-agent: Google-Extended
Disallow: /
Googleのrobots.txtの解釈では、空の「Disallow:」は制限なしとして扱われます。許可の意図を明確にするなら「Allow: /」を記述し、拒否するなら「Disallow: /」のように対象パスを明示します。なお、個別ボットのグループがある場合、一般的な「User-agent: *」のルールがそのまま追加適用されるとは限りません。
出典:Google for Developers「How Google Interprets the robots.txt Specification」
コンテンツ種別やディレクトリごとに方針を分ける場合
記事、商品ページ、画像、PDF、ダウンロード資料で公開目的や権利条件が異なる場合は、URL構造に沿って範囲を分ける方法があります。たとえば、一般公開のニュースは許可し、権利条件が複雑な資料を置く「/downloads/」は特定ボットに拒否する、といった考え方です。
User-agent: GPTBot
Disallow: /downloads/
Disallow: /members/

User-agent: OAI-SearchBot
Allow: /news/
Allow: /products/
Disallow: /members/
ただし、robots.txtのパス指定は利用許諾や著作権表示の代わりにはなりません。資料の利用条件を定めたい場合は、公開ページの利用規約、契約、ライセンス表示、認証方式などを別途整備してください。
WordPressで反映前後に確認したいポイント
WordPressでは、サーバー上の実ファイルとしてrobots.txtを置くケースだけでなく、WordPress本体、SEOプラグイン、キャッシュプラグイン、CDNなどが動的にrobots.txtを出力・変更することがあります。管理画面の設定だけで判断せず、公開URLで実際の応答を確認してください。
- 「/robots.txt」にアクセスし、意図した内容とHTTPステータスが返っているか確認します。
- SEOプラグイン、キャッシュ、CDN、ホスティング側の機能がrobots.txtを上書きしていないか確認します。
- 本番とステージングでURLや公開設定が異なる場合は、ステージングを誤って検索・クロール可能にしていないか確認します。
- 変更前の内容、変更日、変更理由、承認者、戻し方を記録します。
robots.txtだけでは完全に防げないことと追加対策
robots.txtは、対応するクローラーに対してクロール方針を伝える仕組みです。認証・アクセス遮断・著作権ライセンス・過去データの削除を自動で実現する仕組みではありません。守るべき情報の性質に応じて、複数の対策を使い分ける必要があります。
robots.txtとnoindex、ログイン制限は役割が異なる
robots.txtは主にクロール可否を示します。noindexは、対応する検索エンジンの検索結果にページを出さないための指定です。ログイン認証や会員制は、そもそも未認証の利用者・ボットがページ内容を取得できないようにするアクセス制御です。
Googleは、robots.txtだけを検索結果から完全に除外する手段として使わないよう案内しています。robots.txtでクロールを止めると、検索クローラーがnoindexを読めない場合もあるため、検索結果から外したいページは、クロール可能な状態でnoindexを返すか、認証保護、削除など目的に合った方法を検討してください。
出典:Google Search Central「Block Search Indexing with noindex」
機密情報・会員限定情報は公開URLに置かない
個人情報、取引先限定資料、未発表情報、会員限定コンテンツをrobots.txtだけで守ることはできません。URLを知っていれば閲覧できる状態で公開しているなら、robots.txtを参照しない取得者に対して情報が露出する可能性があります。
機密性がある情報は認証の内側へ置くことが基本です。必要に応じて、会員認証、権限管理、期限付きURLの見直し、WAF、レート制限、ダウンロード制限、サーバーログの監視を組み合わせてください。
なりすましアクセスと権利問題は別途対応が必要
ユーザーエージェント文字列は、アクセス元が正規のクローラーであることを単独で証明するものではありません。不審なアクセスがある場合は、ユーザーエージェントだけで許可・拒否を判断せず、提供事業者が案内するIPアドレスや逆引きDNSなどの検証方法、WAFの検知、アクセスログを確認します。
また、コンテンツの学習利用、転載、契約違反、著作権侵害に関する法的評価は、robots.txtの設定だけでは決まりません。第三者の権利が含まれるコンテンツ、ライセンスビジネス、紛争のおそれがある案件では、利用規約と契約を確認し、必要に応じて弁護士へ相談してください。
Cloudflareも、robots.txtは希望を示すものであり、技術的にアクセスを防止するものではないと説明しています。同社のように個別ボットの通信を分析・遮断できるサービスを利用する場合でも、誤検知や通常検索への影響を検証したうえで運用することが大切です。
出典:Cloudflare Developers「robots.txt setting」
設定後は取得状況・検索影響・公式仕様を定期的に見直す
robots.txtは一度公開して終わりではありません。クローラーの名称や用途、robots.txtの扱い、CDNやプラグインの設定は変わり得ます。設定内容と実際のアクセス状況を継続的に照合する運用が必要です。
- 公開URLのrobots.txtを定期的に取得し、意図した内容が配信されているか確認します。
- サーバーログやCDNログで、対象ボットのアクセス先、頻度、HTTPステータスを確認します。
- Google Search Consoleなどで、通常検索のクロールエラーやインデックス状況に変化がないか確認します。
- アクセス解析で、AI検索サービスからの紹介流入を確認できる範囲で記録します。
- クローラー単位の許可・拒否、変更日、理由、承認者、根拠となる公式URLを台帳化します。
- 四半期ごと、またはコンテンツ方針・契約・サイト構造を変更したタイミングで見直します。
AIクローラーの通信量やrobots.txt違反の可能性を確認したい場合、CDNやWAFのログ分析機能が役立つことがあります。Cloudflareでは、AIクローラー別のアクセス状況やrobots.txtとの不一致を確認する機能を案内しています。
出典:Cloudflare Developers「Directives」
AIクローラーの許可設定に関するよくある質問
ここでは、設定時に誤解しやすいポイントを補足します。サービスごとの仕様は変わるため、実装直前には必ず公式情報を再確認してください。
AI検索用クローラーだけを許可できますか?
提供事業者が検索用と学習用で別のユーザーエージェントを公開し、それぞれがrobots.txtを尊重する場合は可能です。たとえばOpenAIでは、OAI-SearchBotとGPTBotが別に案内されています。ただし、Google-Extendedのように、訓練とグラウンディングの両方に関係するトークンもあるため、すべての事業者で同じように細分化できるわけではありません。
AI学習用クローラーを拒否すれば、過去の学習データも消えますか?
いいえ。robots.txtの変更は、原則として今後のクロール方針を示すものです。過去に取得されたデータ、すでに行われた学習、第三者サイトやデータセット経由の利用まで削除・停止させることを保証するものではありません。削除請求や契約上の対応が必要な場合は、対象事業者の窓口・規約を確認し、必要に応じて専門家へ相談してください。
AIクローラーを拒否するとGoogle検索の順位は下がりますか?
GPTBotなど特定のAIクローラーだけを拒否し、Googlebotなど通常の検索クローラーを拒否していなければ、直ちにGoogle検索の順位が下がるという意味ではありません。ただし、robots.txtの編集ミスでGooglebotをブロックすると、クロールや検索表示に影響する可能性があります。変更後はSearch ConsoleやURL検査などで確認してください。
まとめ:サイトの目的に合わせてクローラー単位で判断する
AI検索用クローラーとAI学習用クローラーは、公開コンテンツを取得する点では共通しますが、収集後の主な利用目的が異なります。したがって、「AI検索で見つけられたいか」と「モデル学習を許容するか」を分けて判断することが、サイト運営者にとっての基本方針になります。
まずは、通常検索用のクローラーを誤って止めないよう既存のrobots.txtを確認し、対象事業者の公式情報でユーザーエージェントと用途を確かめてください。そのうえで、公開情報、独自ノウハウ、会員限定情報、第三者権利を含む素材を区別し、必要ならディレクトリ単位で制御します。
robots.txtは有用な意思表示ですが、完全なアクセス制御や法的な権利処理の代替ではありません。非公開にすべき情報は認証の内側に置き、アクセスログ、WAF、利用規約、契約、専門家への相談を含めて、事業上のリスクに見合う運用を設計してください。